
MORI:idleness 不是二元标签,而是随硬件容量滑动的相对谱
Tian Xia, Hanchen Li, Zhifei Li 等 · UC Berkeley / Renmin University / Stanford / Georgia Tech · arXiv 2026(cs.OS)
Paper(v1,2026-05-30 提交;本文数字核对于 2026-10-10)
LLM serving 正在从"一问一答的 chat 请求"转向"长跑的 agent 程序":一个 Claude Code 会话会发出几十次模型调用,中间穿插工具调用,每次调用都把结果追加进上下文,累积起一份横跨整个会话、可以跨步复用的 KV cache。这份 working set 很容易超出 GPU HBM,于是系统把它卸载到 CPU DRAM——但工具调用时长横跨三个数量级以上,从几百毫秒的文件读写到按分钟计的测试套件和人工确认,而且在调用结束之前无人能预知它属于哪一种。
MORI(Memory Offloader with Relative Idleness)的出发点是一个重新表述:调度器要回答的不是"这个程序闲不闲",而是"在当前这块硬件上,它比谁更该待在 GPU 里"。它为每个程序维护一个窗口化的连续 idleness 分数,把最忙的程序放进 GPU HBM、最闲的放进 CPU DRAM,并让两层之间的分区边界随硬件容量比动态滑动。在从 Claude Code 采集的真实编码负载上、跨四组 GPU 与模型配置,MORI 在 80 并发程序下比最强的 offloading baseline 高出 20–71% 吞吐、降低 18–43% TTFT。
Why MORI?
先看旧方案各自卡在哪里。Chat 时代的 KV cache offloading 之所以成立,是因为轮次间隔由人类打字主导——几十秒的空窗足够从容地卸载再加载。Agent 负载把这个前提推翻了:工具调用以几百毫秒为单位密集到来,每次调用间隙都做卸载,传输成本会吃掉整个空窗。于是近年一批 program-aware 系统(Continuum、ThunderAgent、Infercept 等)改为在工具调用期间把程序的 KV cache 钉在 GPU HBM 里。但钉住是有代价的:并发程序的总 KV cache 一旦超过 HBM,就必须整体驱逐某个程序,等它恢复时从零重算 prefill,既浪费 GPU 周期又抬高延迟。
最直观的补救是按次决策:短调用就留在 GPU,长调用就趁机卸载。这条路走不通,因为调用时长取决于 serving 系统看不到的外部因素——一条 shell 命令可能几百毫秒返回,一次 pytest 可能跑几分钟——事先预测单个调用的时长并不可靠,而每次调用边界都搬运 KV cache 的开销又会压垮短调用。
那么退一步,用更粗的粒度呢?MORI 的 trace 分析给出了一个可利用的结构:532 个 Claude Code 程序呈现出清晰的两相行为——busy phase 是一连串几百毫秒的短调用,idle phase 则阻塞在秒级到分钟级的长调用上。以 2 秒为短长分界,87% 的调用是短调用,但剩下 13% 的长调用吃掉了 58% 的墙钟工具时间;busy phase 的中位时长约 20 秒(p90 约 81 秒),相位足够持久,调度器来得及利用。看起来一个二元 busy/idle 标签就能解决问题。
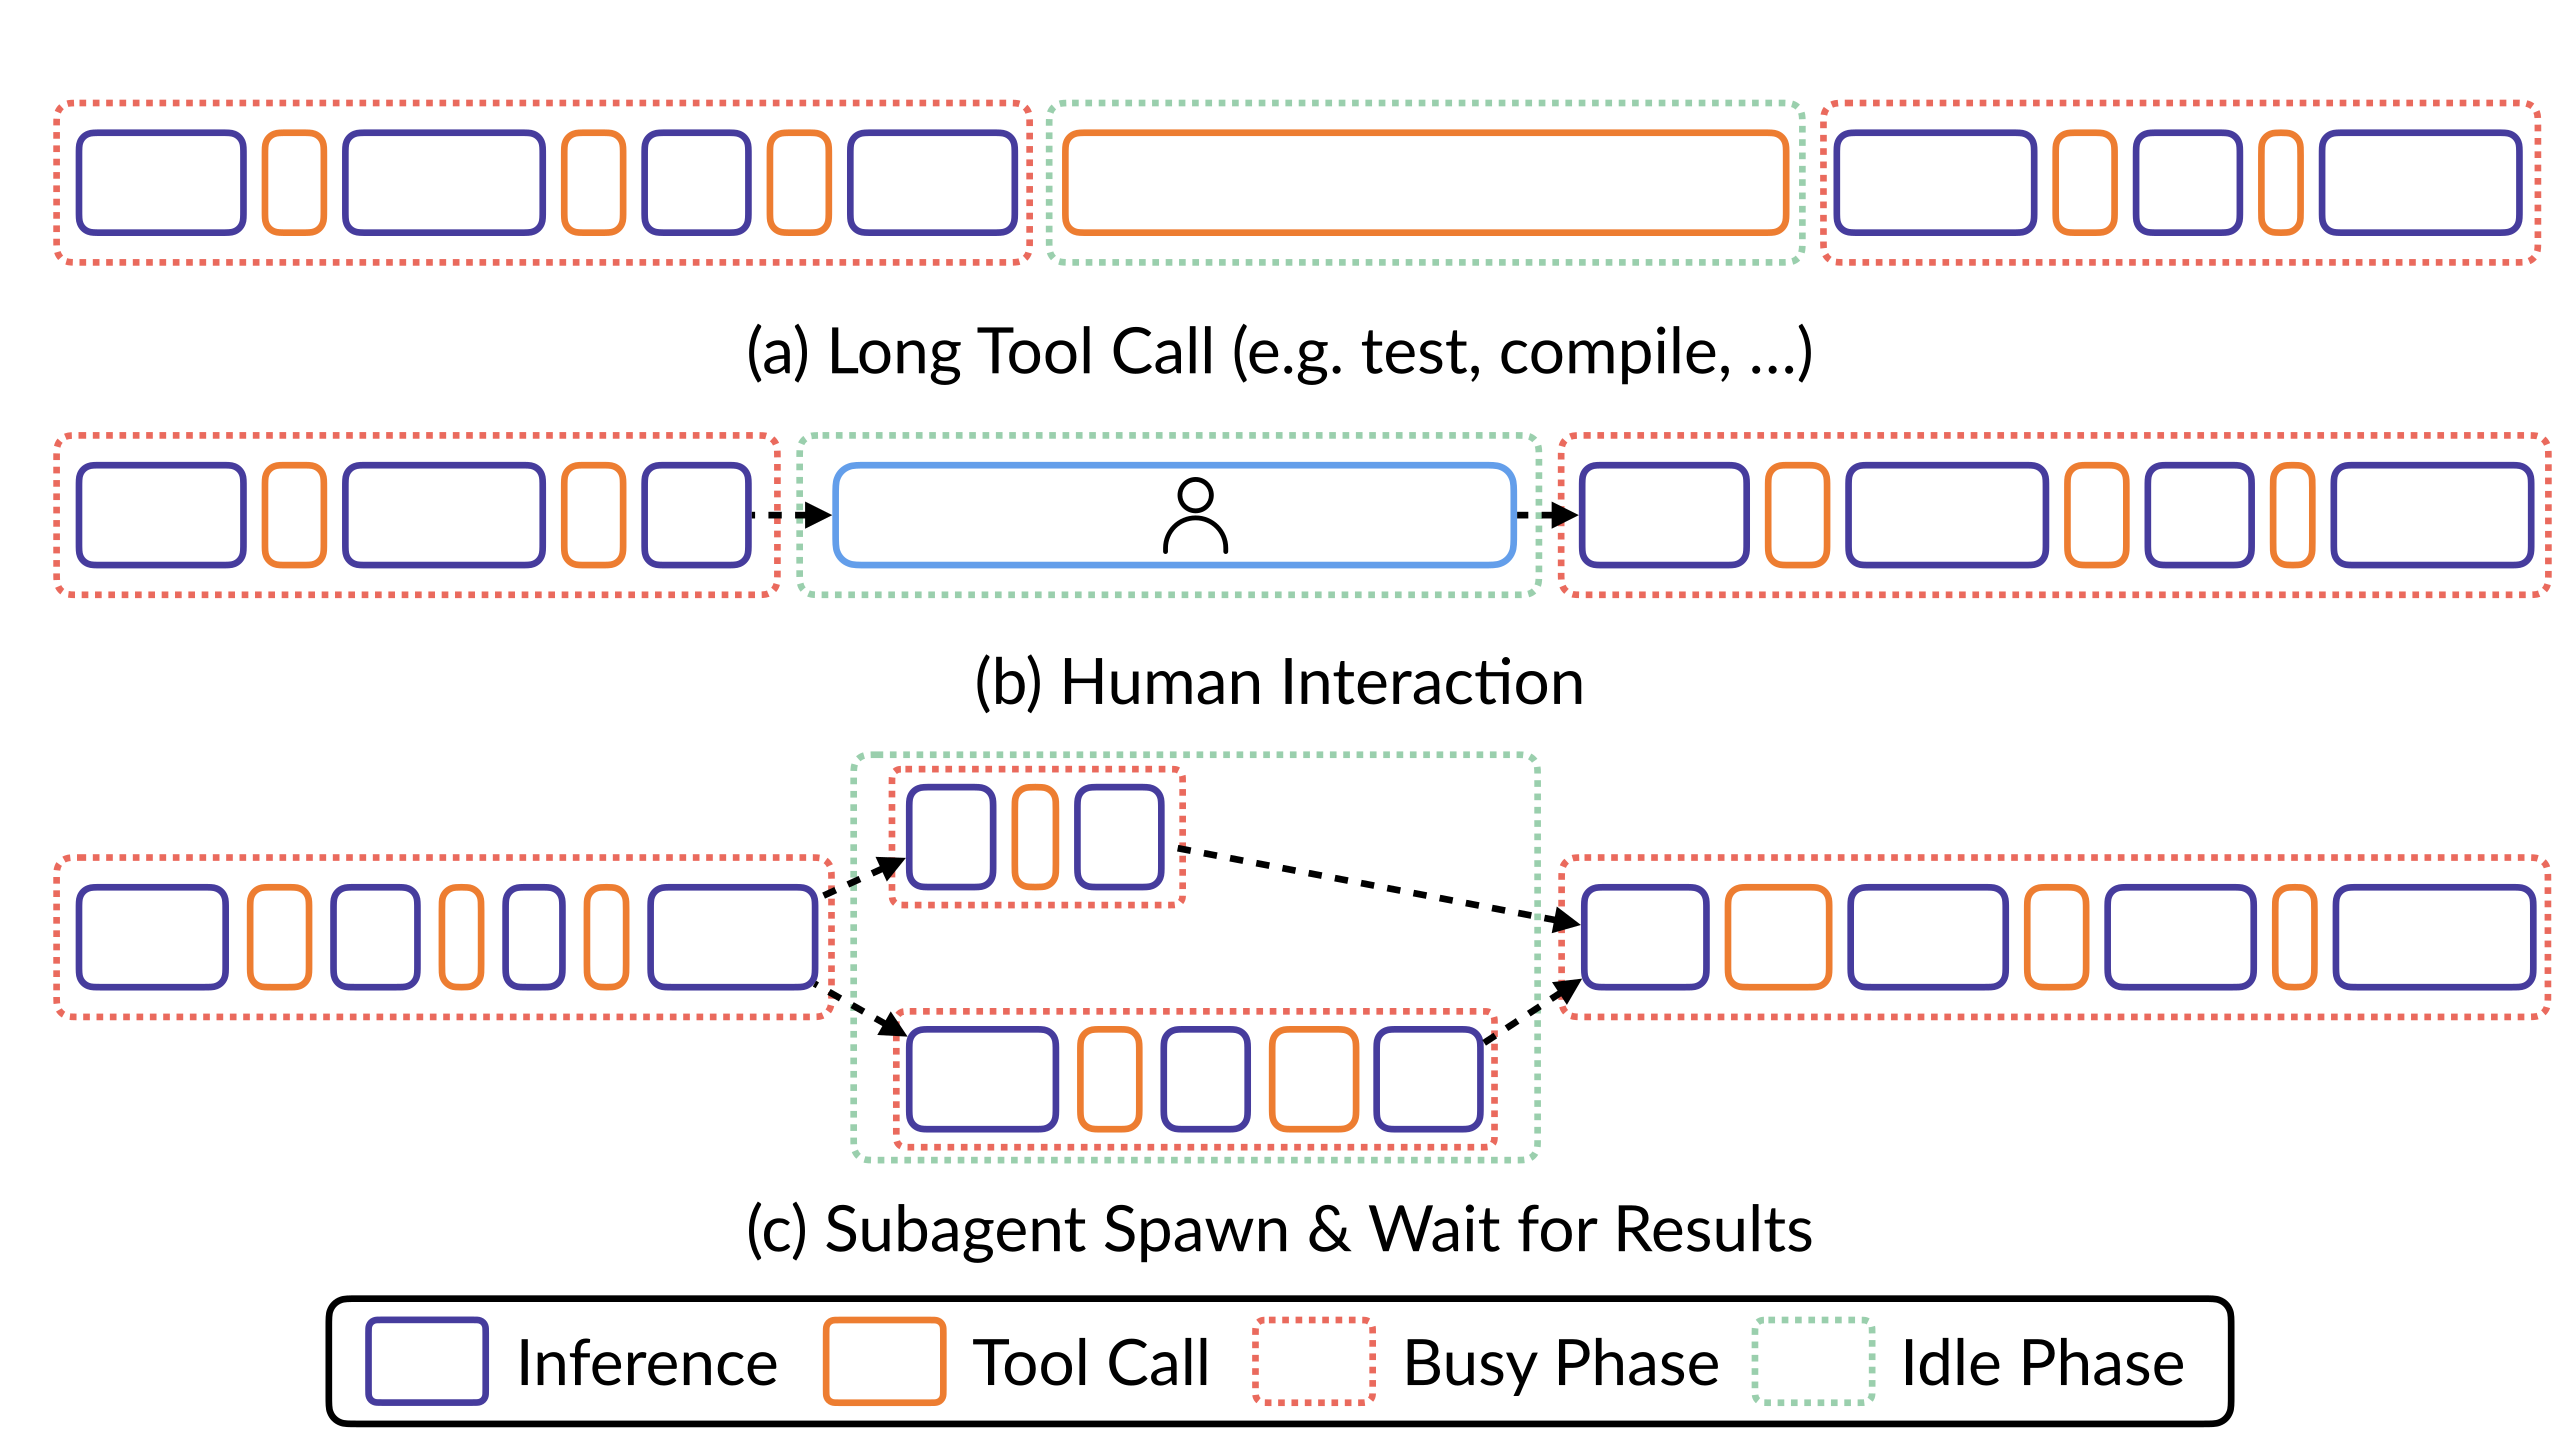
来源:原论文 Figure 4。读图重点:idle phase 由少数长调用触发且持续整段空窗,父 agent 等 subagent 时自己也是 idle 的——这正是可以被卸载利用的窗口。
但二元标签在放置环节失灵了。程序的相位在持续切换、上下文在持续增长,busy 程序与 idle 程序的内存需求之比随时间波动;而任何一台机器的 GPU HBM 与 CPU DRAM 容量之比是固定的。两者对不上时,按固定阈值切出来的"busy 组"可能塞不进 HBM,被迫驱逐即将恢复的程序,同时另一层内存却空着。同一台 DGX 节点配 1 TB 还是 2 TB DRAM,GPU:CPU 容量比从 1:1.6 变成 1:3.1,任何固定的 busy/idle 划分都不可能同时适配。此外,CPU DRAM 本身也有限——先前工作只做 GPU 侧准入控制,卸载过去的 idle 程序同样会互相驱逐、引发 DRAM 侧的 thrashing。
这就是论文的转折点:所有失败方案都在问"这个程序是不是 idle",而真正该问的是一个相对量——
在这台机器的容量比之下,谁比谁更该留在 GPU?
How MORI Works
关键洞察:idleness 是连续且相对的谱
MORI 不预测单次工具调用的时长,而是从程序最近的行为估计它当前所处相位。定义 idleness 为最近
"相对"体现在用法上:ι 不与任何绝对阈值比较,只用于把全部活跃程序排序。busy 程序多到装不下 HBM 时,边界自动上移、多挤走几个最闲的;busy 程序少时,边界自动下移、GPU 少放几个也够了。同一个策略无需逐硬件调参就能适配任何 GPU:CPU 容量比——这正是二元标签做不到的。
设计
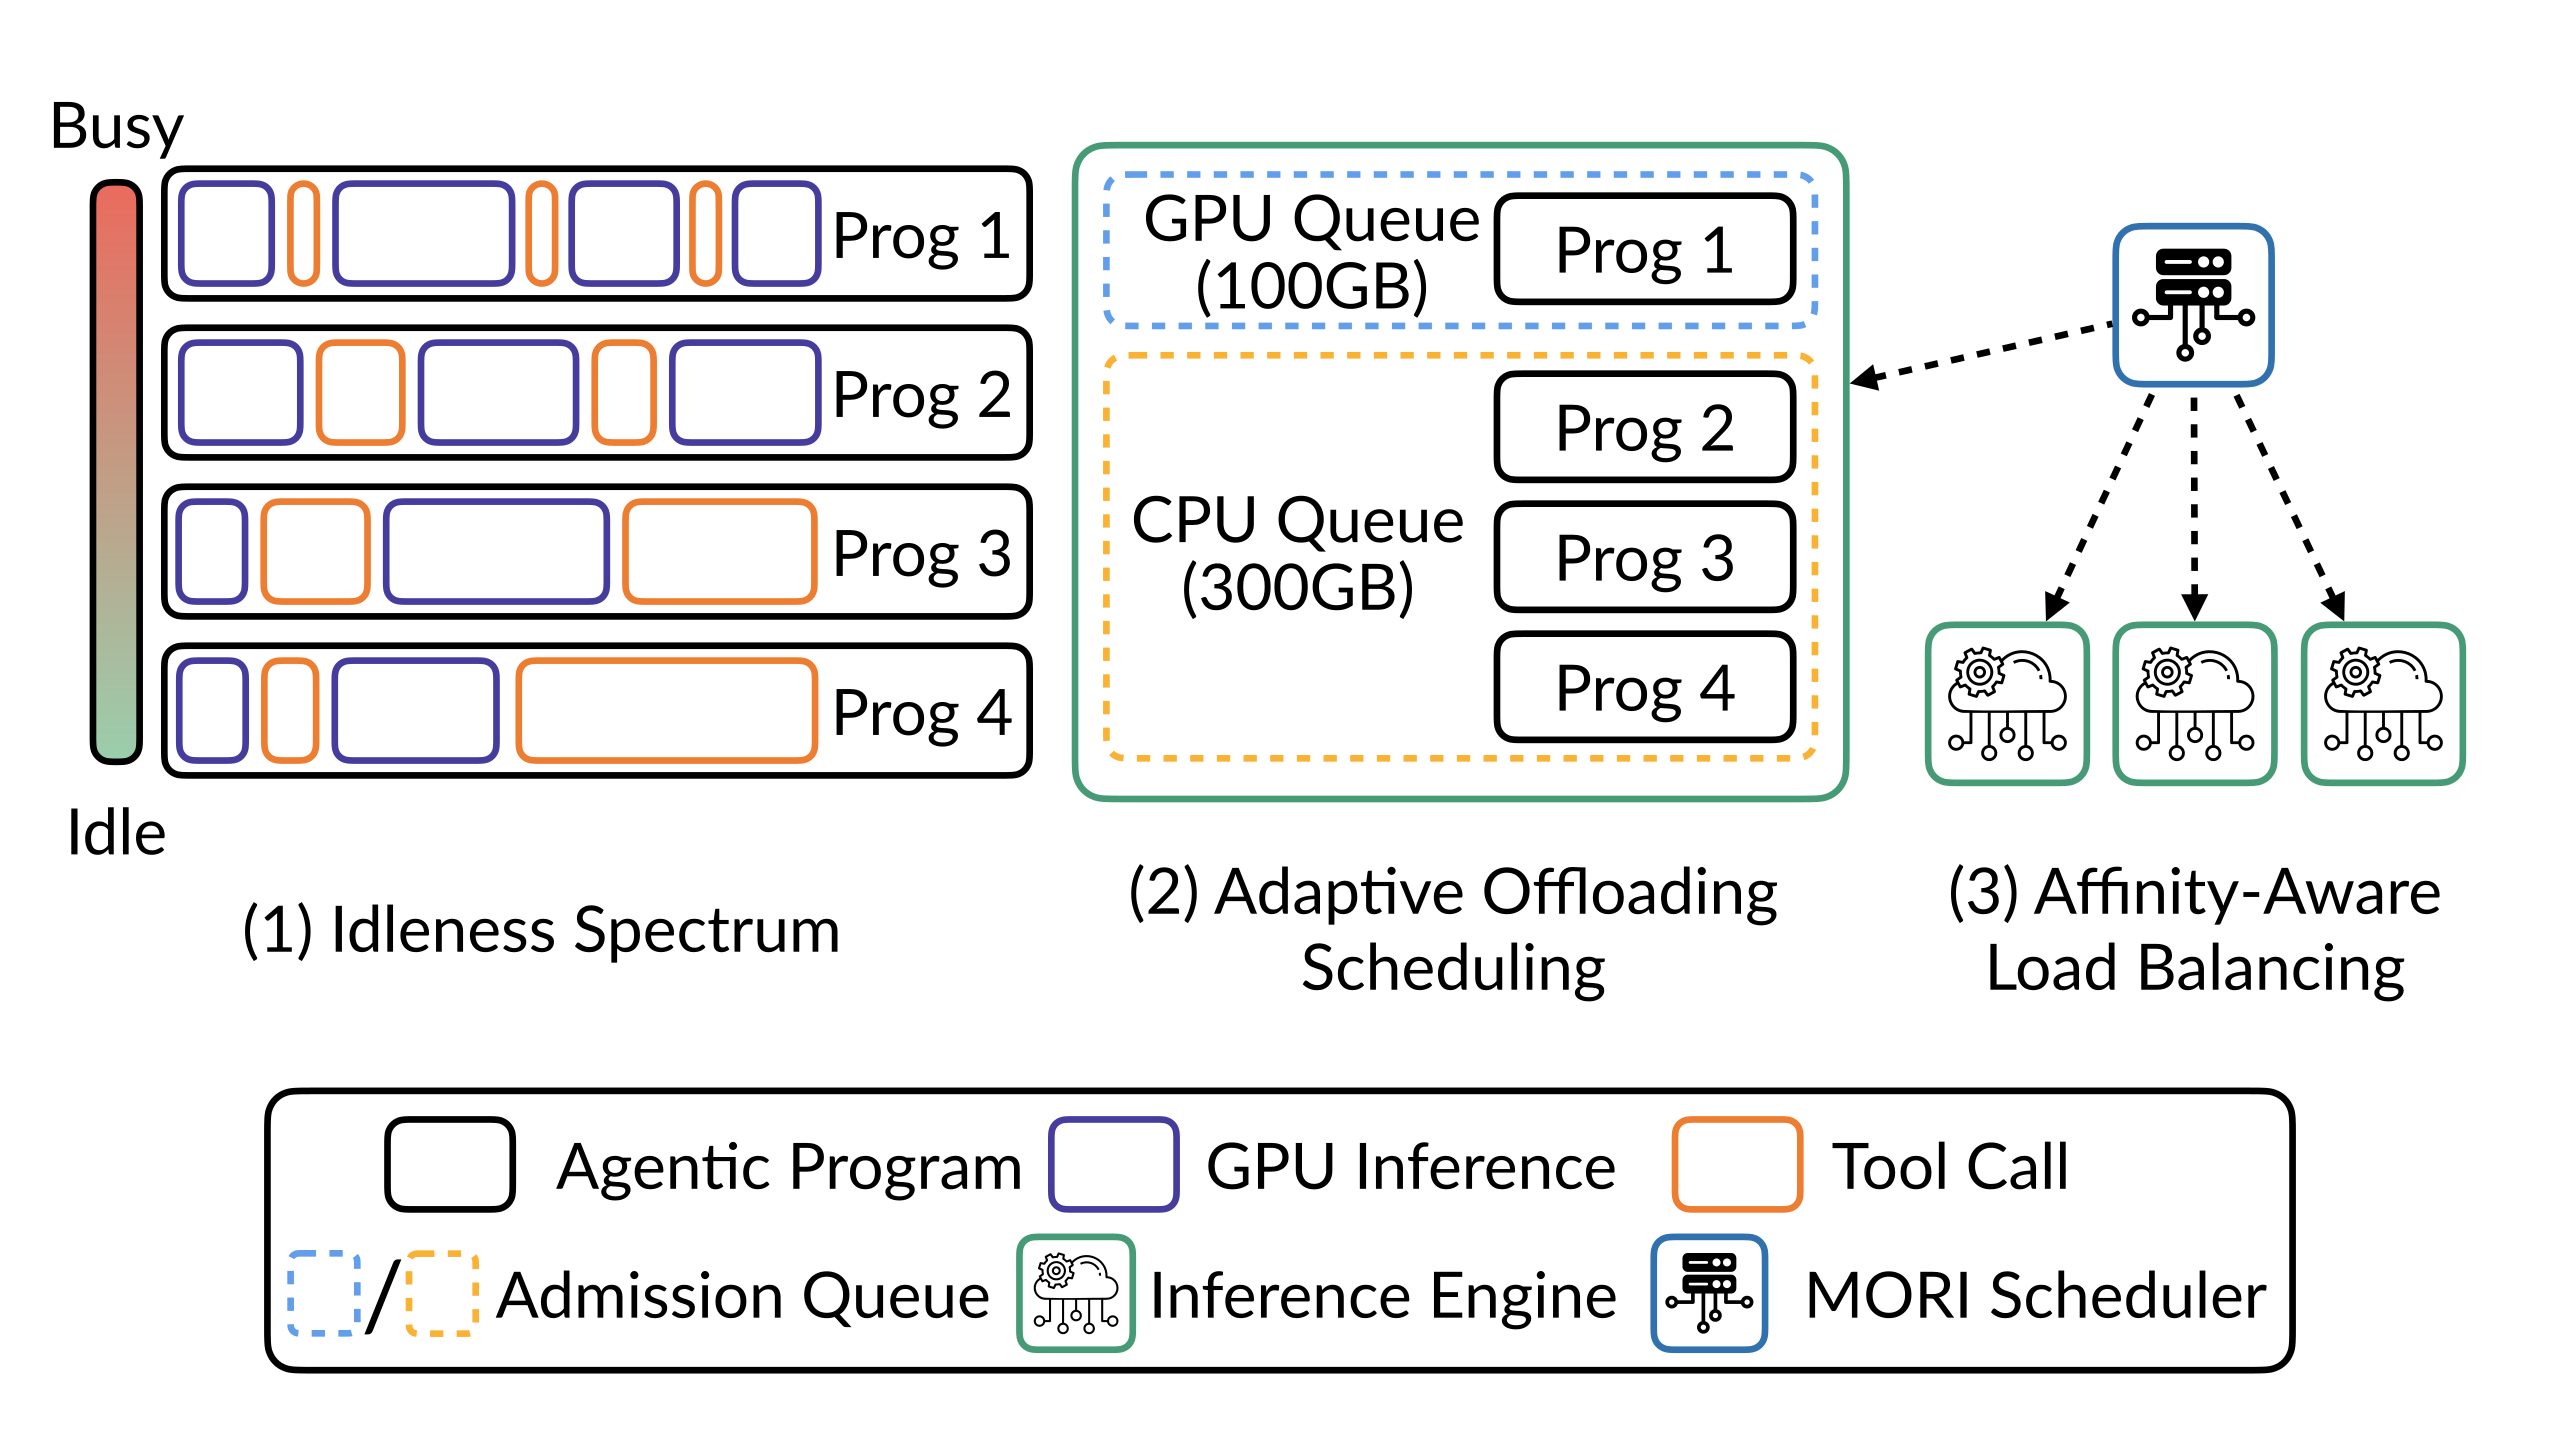
来源:原论文 Figure 1。读图重点:程序按 ι 排成一条谱,GPU/CPU 的分区切在这条谱上并可移动,而不是切在某个固定的"busy/idle"分类线上。
三层队列 + sticky 放置。 调度器把程序组织进 GPU 队列(HBM)、CPU 队列(DRAM)和 Waiting 队列(KV cache 已丢弃,恢复需全量重算),两层各自执行准入控制,装不下的进 Waiting。放置是粘性的:程序留在原层级,直到容量被打破才把 ι 最高的 Acting 程序降级(若全是 Reasoning 程序则 lazy demotion,等当前推理步做完再搬);GPU 空出容量时,优先把已结束工具调用、ι 最低的 CPU 程序提升回来。层级切换不是免费的(KV cache 要走 PCIe),只在必要时重排,避免频繁搬运的 churn。
Typed offloading。 调度器决定程序在哪一层,但引擎内部仍按 block 管理缓存。MORI 把 busy/idle/inactive 标签盖在引擎 radix tree 的 KV 节点上,并让两级驱逐优先级互为倒置:GPU 侧最后才驱逐 busy 的块,CPU 侧最后才驱逐 idle 的块——每层都优先留住分给它的程序。标签同样用于调度:busy 类型的等待请求先进入下一个 batch。
亲和感知的多副本负载均衡。 CPU 队列按副本维护,程序卸载的 KV cache 就存在计算它的那个节点的 DRAM 里;程序恢复时优先路由回原副本,从本地 PCIe 重载而不是跨副本重算。作为对比,不感知 CPU 层的调度器一旦程序被逐出 GPU 就当作无状态,按负载重新分配副本,强行打破亲和。
实现上,MORI 构建在 ThunderAgent 调度器与 SGLang v0.5.10(HiCache 作为卸载后端)之上,约 3300 行调度器代码加 500 行引擎缓存代码。客户端唯一的要求是在 OpenAI 兼容请求里带上 program_id,不需要任何工具调用标注或相位提示;调度器以默认 5 秒的周期异步运行。
Results
实验将 186 条完整的 Claude Code trace(跑 SWE-bench Pro 测试集、claude-sonnet-4-6 采集)重放到四种配置上:H200(限至 80 GB,模拟 H100 级容量)配 Qwen-2.5-7B、H200 配 Qwen-3-30B-A3B(DP=1 与 DP=3)、B200(TP=2)配 Llama-3.1-70B;CPU:GPU 容量比各测 1× 与 2×。基线为 SGLang Model Gateway(SMG)、ThunderAgent(TA)与 TA+O(TA 加上不经协调的 HiCache offloading)。客户端是闭环回放,每档并发 20/50/80,每场一小时。
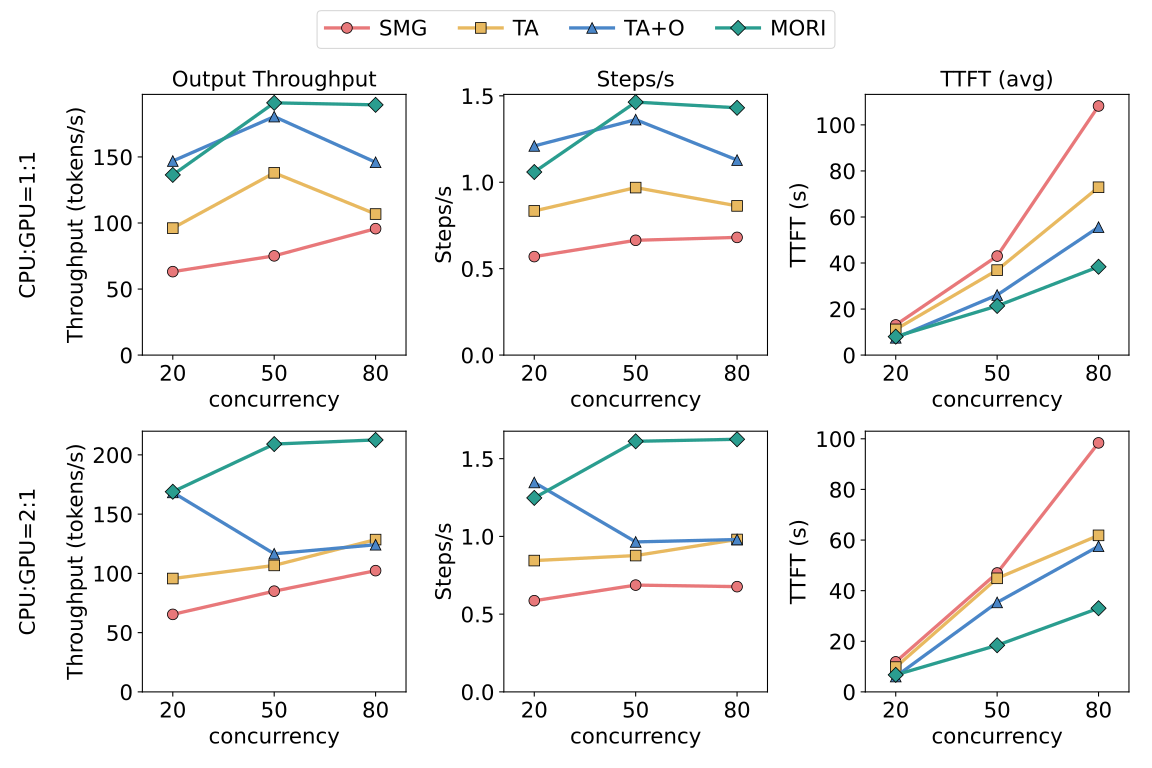
来源:原论文 Figure 9。读图重点:内存最紧张的 B200 配置差距最大——TA+O 的吞吐在 80 并发时不升反降,MORI 保持单调增长;这直接验证相位感知放置在高内存压力下的价值。
单副本上,MORI 在三种配置的 80 并发下全部拿到最高吞吐:比 TA+O 高 20–71%,比不做 offloading 的 SMG 和 TA 高 1.6–2.1×。B200 配 2× CPU 内存时是差距的极值:MORI 213 tokens/s 对 TA+O 的 124 tokens/s(+71%)。低压力时优势按预期消失——20 并发下 working set 装得下 CPU 层,MORI 与 TA+O 只差 2%,此时相位感知无处发力;压力越大、驱逐越不可避免,驱逐策略的质量才越关键。TTFT 的故事一致:B200 80 并发下 SMG 平均 108 秒、TA 73 秒、TA+O 56 秒、MORI 38 秒,相对 SMG 降低 2.8×。一个说明协调价值的细节:把 CPU 内存从 1× 翻到 2×,MORI 的 TTFT 从 38 秒降到 33 秒,TA+O 纹丝不动(56→58 秒)——多出来的容量只对知道怎么用它的人有用。
调度开销方面,MORI 的每步 CPU 调度延迟从 TA+O 的 21.5 ms 增至 23.8 ms,但与约 32 ms 的 GPU step 完全重叠,不进入关键路径。
多副本(DP=3)进一步放大差异。80 并发时 MORI 比 TA+O 高 54–79% 吞吐,GPU 利用率保持 99%+,而相位不感知的 TA 与 TA+O 只有 59–76%、吞吐随并发不升反降。机制在亲和上:TA/TA+O 的程序被逐出 GPU 后会被重新分配副本,20 并发下就有 14–15% 的程序至少换过一次后端,每次切换都要在新副本全量重算前缀;MORI 追踪两层缓存驻留,只有 0.3–2.9% 的程序发生切换。
证据边界值得写明:所有结果来自回放的 trace 而非真实在线流量,负载只覆盖编码 agent 一种形态;低并发下与简单 offloading 持平说明收益集中在内存超售的高并发区间;扩展到 SSD 或跨节点 RDMA 层、异构硬件上的跨副本准入,论文停留在讨论而非实现。
Conclusion
MORI 证明了:把 KV cache 放置从"分类问题"改写成"排序问题",一套策略就能同时吃到相位结构与硬件容量比。 窗口化 ι 从程序近期行为里读出相位,sticky 三层放置把边界切在相对排序上、由两层准入控制兜底,typed offloading 保证引擎的逐块驱逐与调度器的程序级决策一致——四组配置上 20–71% 的吞吐增益在内存紧张时最显著,在低压力时按预期退化为持平。
更值得带走的是视角变化: 当负载的工作集动态涨落而硬件容量比固定时,绝对阈值注定顾此失彼,"相对于其他程序和这台机器,它排第几"才是可迁移的调度信号——这个思路同样适用于论文展望的 SSD、远端 DRAM 与异构集群。