
Sarathi:让解码搭上 prefill 的顺风车
Amey Agrawal, Ashish Panwar, Jayashree Mohan, Nipun Kwatra, Bhargav S. Gulavani, Ramachandran Ramjee · arXiv 2023
Paper · Code(后续 Sarathi-Serve 仓库)
LLM 推理有两条性格完全相反的阶段:prefill 一次吃下整个 prompt,批大小为 1 就能榨干 GPU 算力;decode 逐 token 自回归生成,本质是向量-矩阵乘,算术强度比 prefill 低两个数量级,只能靠大 batch 摊薄读权重的开销——而 batch 又被 KV cache 的显存占用死死卡住。论文实测(LLaMA-13B,A6000,序列长 1024):decode 的每 token 成本是 prefill 的 200x(批大小 1)、16.7x(批大小 18);要靠 batch 饱和 GPU,decode 需要约 256 的批大小,实际却最多只能装下 18 个请求。吞吐的瓶颈就卡在这条漫长的低效解码尾巴上。
Sarathi 的解法是重新定义"一个批次":用 chunked-prefills 把长 prefill 切成等大的 chunk,每个 chunk 自身就是计算饱和的批次;再用 decode-maximal batching 在 chunk 之外把剩余槽位全部塞进解码请求——线性层的权重从显存读一次,同时服务 prefill 和 decode,解码从 memory-bound 变成 compute-bound。论文报告,LLaMA-13B/A6000 上解码吞吐最高提升 10x、端到端吞吐最高提升 1.33x,LLaMA-33B/A100 上分别为 4.25x 与 1.25x;用于 GPT-3 的 64 卡流水线并行部署时,均匀批次把 pipeline bubble 减少 6.29x,端到端吞吐提升 1.91x。
Why Sarathi?
先看两个既有方案为什么都没解到这一层。请求级调度(FasterTransformer 一类)把一批请求从头跑到尾,短请求被迫 padding,浪费明显;Orca 与 vLLM 的 iteration-level scheduling(即 continuous batching)允许逐迭代增删请求,已经好得多——但它没有改变一件事:一个迭代要么是 prefill、要么是 decode。解码迭代依然是 decode-only 的 memory-bound 计算,batch 上限由可容纳的批大小
那么把 prefill 和 decode 混进同一个迭代呢?iteration-level scheduling 确实会这样做,但论文指出这只是副作用:它把整个 prompt 一次性提交为一个完整 prefill,动辄 1K-4K token 的 prefill 独占整个迭代的执行时间,同批的解码请求在期间实际是被拖住的;混批能否发生、混多少,完全取决于请求到达和离开的时机。要系统性受益,批次必须被"设计"出来,而不是靠运气撞上。
能否构造出一种批次,让每个迭代既把 GPU 喂饱、又保持计算量均匀——解码请求随之以近乎免费的成本跟车执行?
How Sarathi Works
关键洞察:两条利用率曲线可以互补
论文的分析给出一个干净的观察:prefill 的每 token 成本几乎不随 batch 变化——单请求、只要 token 数够多(LLaMA-13B 在 A6000 上约 512),prefill 就已达到约 180 token/ms 的饱和吞吐;而 decode 只有在极大 batch 下才可能接近饱和,现实中又达不到。既然一个中等长度的 prefill chunk 自身就是饱和批次,而 decode 的线性层与 prefill 共用同一套权重,那么让解码 token 与 chunk 同批执行,就能把 decode 的计算嫁接到 prefill 早已读入显存的权重上——decode 的瓶颈(读权重)被 prefill 顺带解决了。
Chunked-prefills:把 prefill 切成饱和的等分
切分不改变数学结果:Sarathi 逐 chunk 递进设置 attention mask,第
Decode-maximal batching:顺车的账本
每个混合批次由一个 prefill chunk 加尽可能多的解码请求构成(解码数至多
| 批次方案 | 线性层 (ms) | Attention (ms) | 总时间 (ms) | 每 token 时间 (ms) |
|---|---|---|---|---|
| Prefill-only(4 条 1024-token prompt) | 224.8 | 10.0 | 234.8 | prefill 0.229 |
| Decode-only(批大小 4,序列长 1024) | 44.28 | 5.68 | 49.96 | decode 12.49 |
| Decode-maximal(1021 prefill + 3 decode) | 223.2 | 15.2 | 238.4 | decode 1.20 |
根据原论文 Table 2 重绘。读表重点:混合批次相对纯 prefill 批次只多花 3.6ms,但 3 个解码请求的每 token 成本从 12.49ms 降到 1.2ms——约一个数量级的差距,全部来自权重复用。
chunk 大小还决定"车"能装多少:chunk 越小,同样长度的 prefill 产生越多 chunk、每个 chunk 能搭载的解码请求越多。论文用 P:D 比(批次内 prefill 与 decode token 数之比)刻画这一点——chunk 128 时 P:D 超过约 42 即可让全部解码随车,chunk 256 则要超过约 84;chunk 过小则 prefill 自身掉效率。理想 chunk 大小取决于模型、硬件与负载的 P:D 分布,论文用一次性的离线 profiling 选定,并把自适应选择留作未来工作。
均匀批次消灭流水线气泡
同一设计还解决多机部署的另一笔账。Pipeline parallelism 通信开销远低于 tensor parallelism,适合跨节点部署,但每个迭代的执行时间取决于其中 prefill/decode 的构成——论文识别出三类气泡:相邻微批 prefill token 数不同、prefill 与 decode 执行时间不同、各请求累积上下文长度不同。Orca 式迭代级调度并不消除这些气泡。chunked-prefills 恰好把所有微批变成等计算量的单元,每个阶段的等待时间随之坍缩。
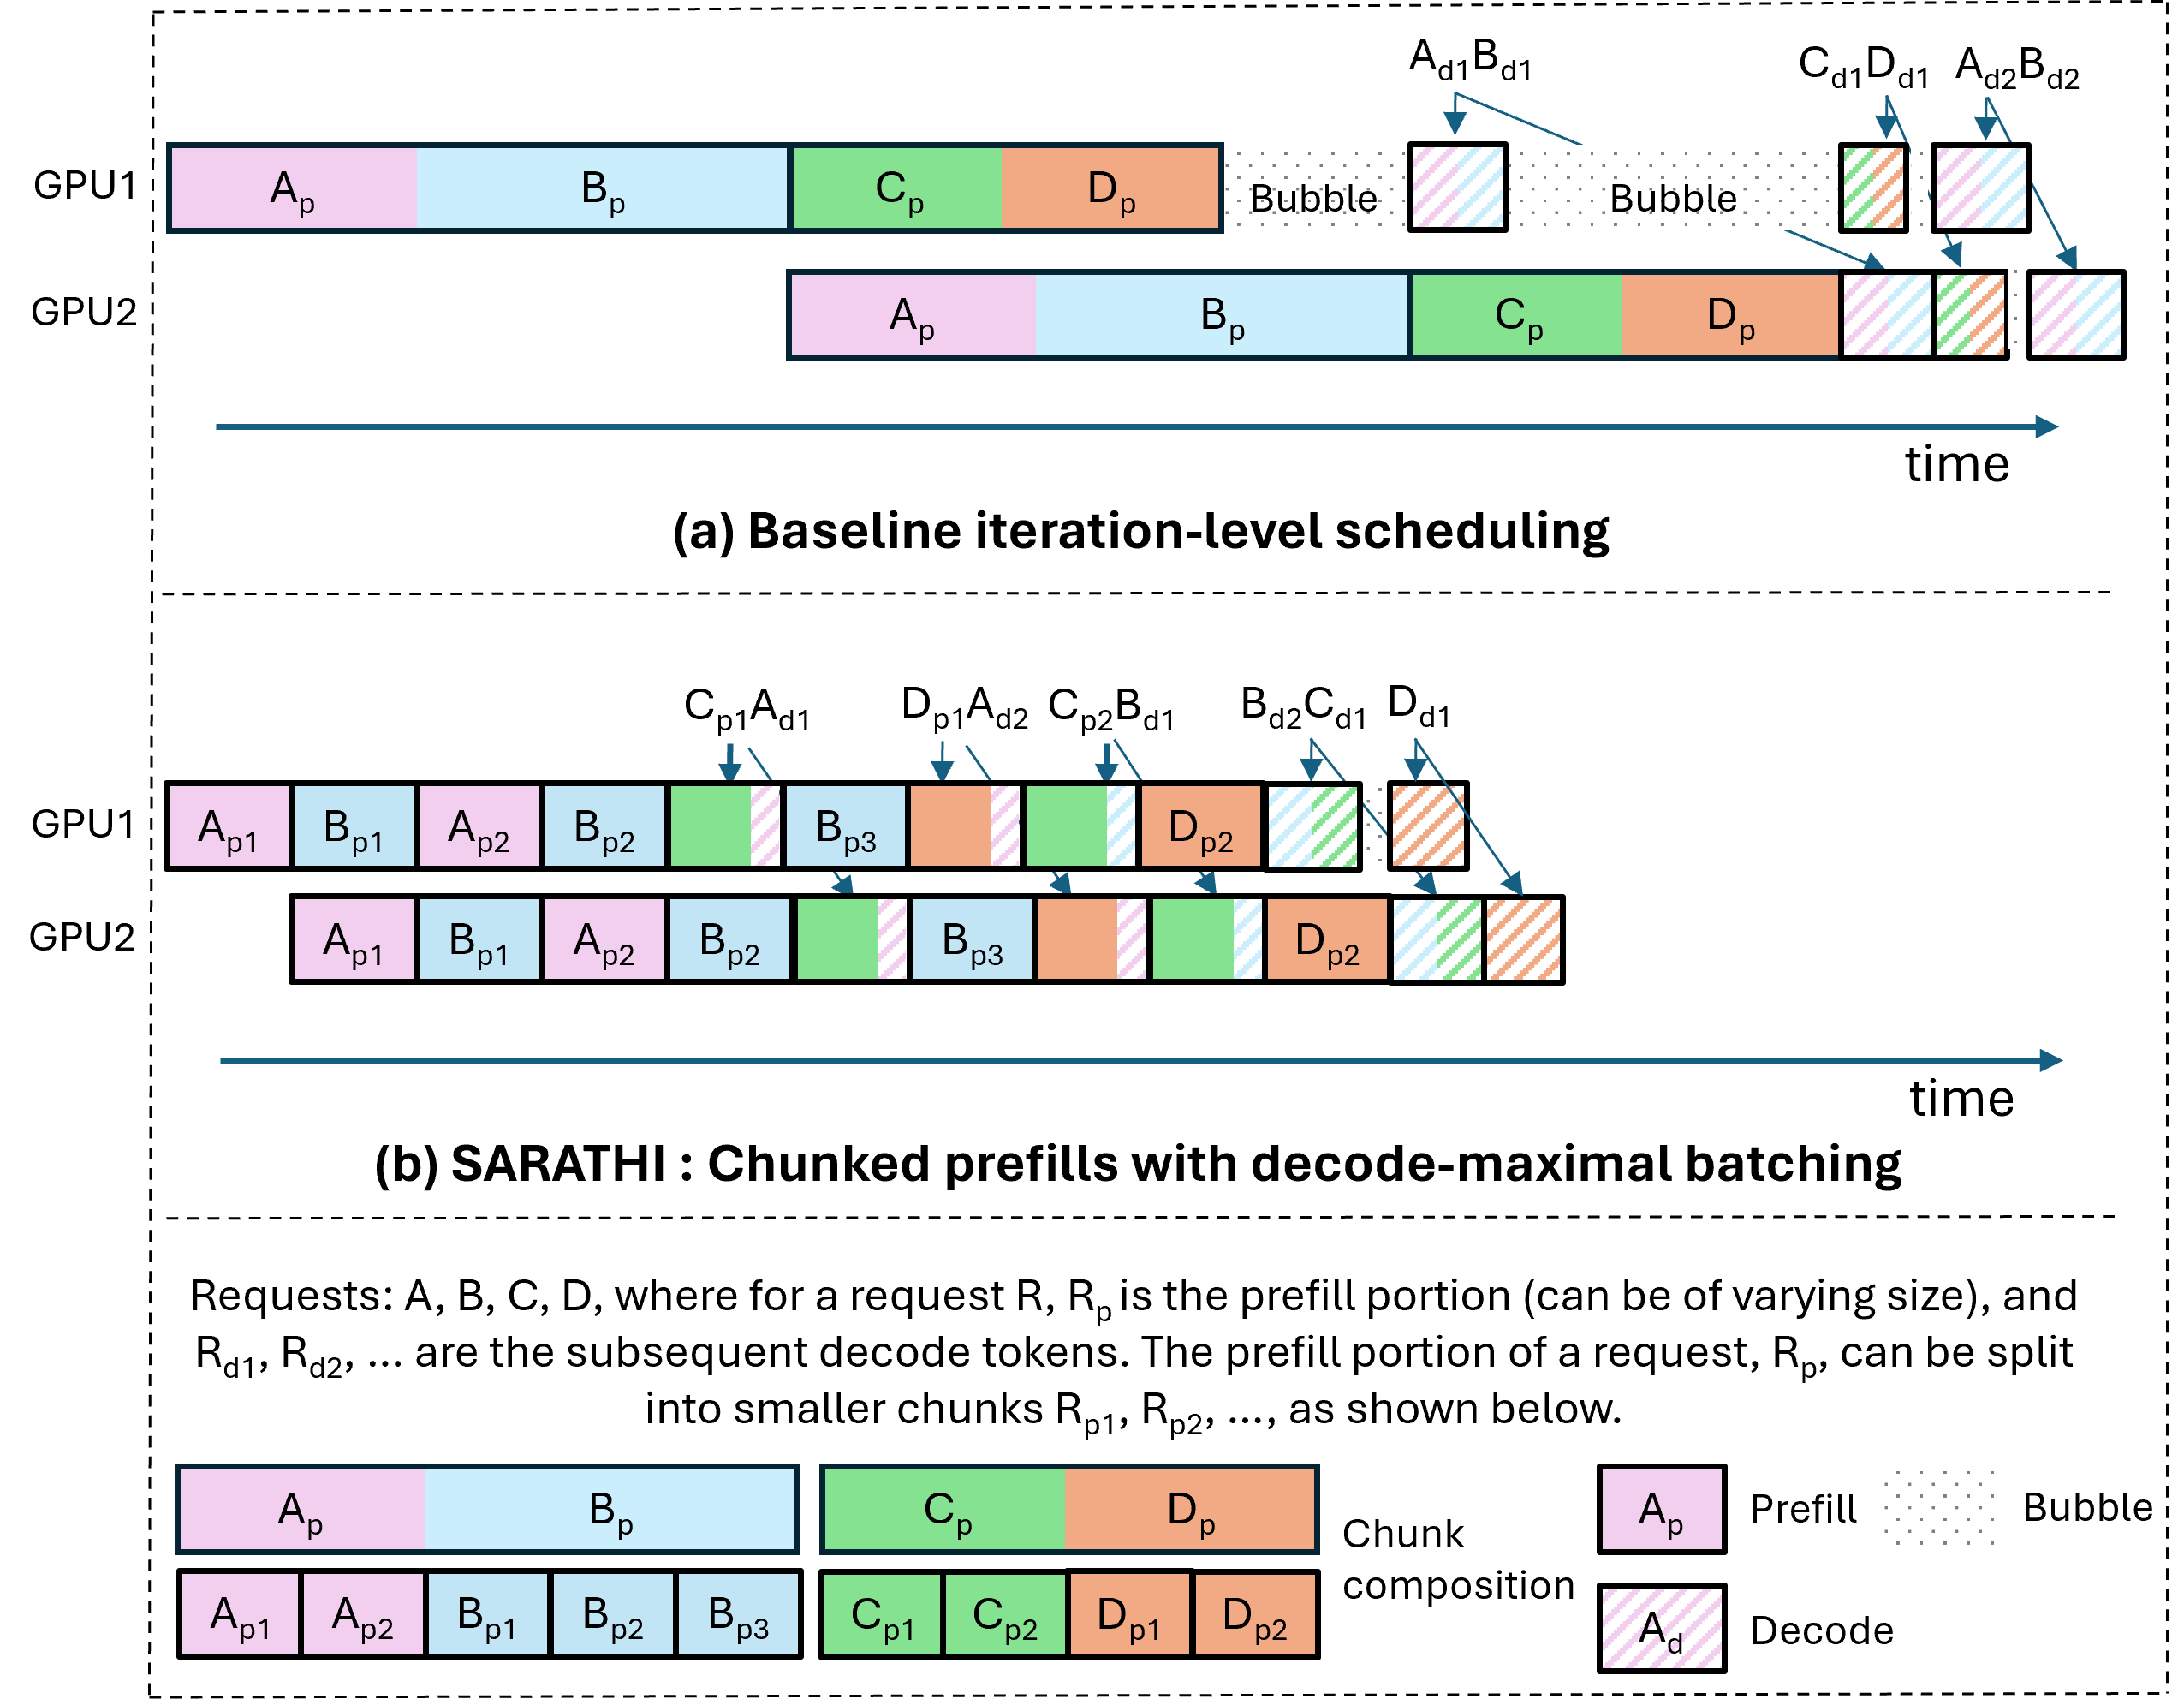
来源:原论文 Figure 1。读图重点:上图与下图的差异不是某个 kernel 变快,而是每个迭代承载的计算量变得均匀——这是 bubble 与解码效率同时改善的原因。
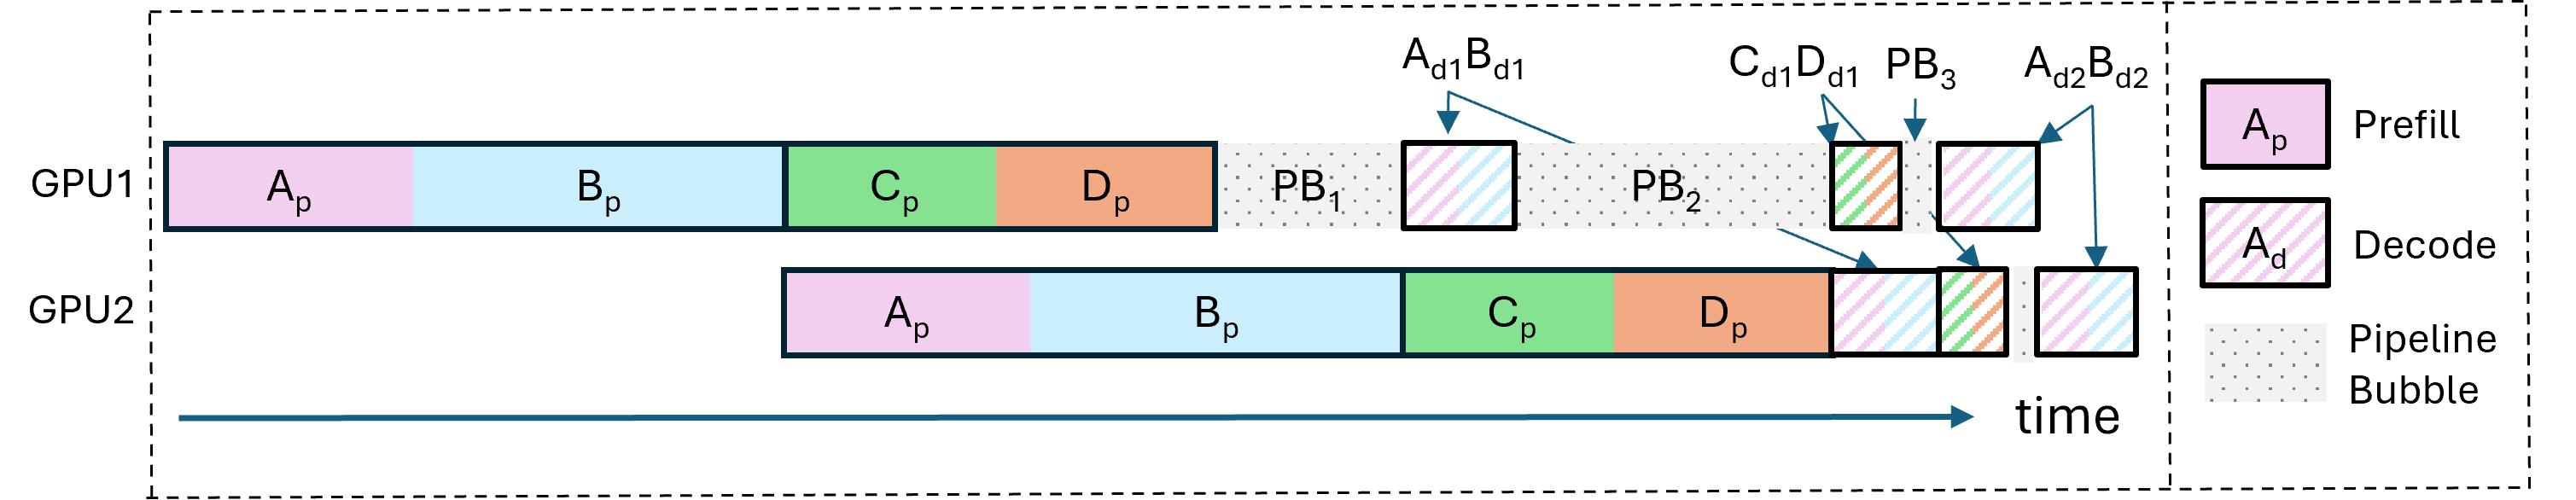
来源:原论文 Figure 5。读图重点:三类气泡对应三种微批间计算量失配,都是"迭代执行时间不均匀"这一个根因的不同表现。
Results
实验设置:Sarathi 实现在 nanoGPT 代码库上,attention 用 xformers;单机部署实验为 LLaMA-13B(A6000 48GB)与 LLaMA-33B(A100 80GB),chunk 大小 256;基线是 prefill/decode 分批处理的传统调度,另与 Orca 式迭代级调度对比。解码吞吐提升的口径是混合批次相对同规模 prefill-only 批次的边际时间差——即"搭车的真实成本"。
| 模型(GPU) | 序列长 | 批大小 | P:D | 解码吞吐提升 | 端到端吞吐提升 |
|---|---|---|---|---|---|
| LLaMA-13B(A6000) | 1K | 6 | 50:1 | 5.45x | 1.33x |
| LLaMA-13B(A6000) | 2K | 6 | 50:1 | 3.26x | 1.26x |
| LLaMA-13B(A6000) | 3K | 6 | 50:1 | 2.51x | 1.22x |
| LLaMA-33B(A100) | 1K | 10 | 28:1 | 3.83x | 1.25x |
| LLaMA-33B(A100) | 2K | 5 | 63:1 | 4.25x | 1.22x |
| LLaMA-33B(A100) | 3K | 3 | 127:1 | 3.51x | 1.14x |
根据原论文 Table 4 重绘(chunk 大小 256)。读表重点:解码加速随序列变长而收窄——attention 开销随序列二次增长,而 Sarathi 的收益全部来自线性层。
单机结果:解码吞吐提升在 2.8x-10x 之间,端到端吞吐最高 1.33x;论文还验证了即便在 Orca 式调度最有利(新旧请求自然交错)的情形下,完整 prefill 独占迭代这一点也使其混批能力远低于 decode-maximal batching。流水线结果基于一个经校准的模拟器(在 8 卡 A100 DGX 上与实测误差 5% 以内):GPT-3 部署在 8 台机器共 64 张 A100 上,Sarathi 把每请求的中位 bubble 时间减少 6.29x;基线中纯 TP 部署反而比带 Orca 调度的 TP+PP 快 1.28x(气泡吃掉了 PP 的通信优势),而 Sarathi 让 TP+PP 达到 1.91x 于基线、1.48x 于纯 TP——流水线并行重新变得有竞争力。
证据的边界:单机实验的请求序列长上限为 3K、P:D 覆盖 1-200,更长序列下 attention 二次增长会进一步压缩收益;流水线结果是模拟而非实测硬件;论文假设同批请求的 prefill/decode token 数一致,真实负载的方差未建模。还有一个结构性的未解项:搭车拉长了每个迭代的执行时间(Table 2 中 238.4ms 对 234.8ms),正在解码的请求 token 间隔会随之波动——吞吐与解码延迟之间的调度权衡,论文明确留作未来工作,其后续 Sarathi-Serve(OSDI 2024)正是补上这一块。
Conclusion
Sarathi 证明的是:batch 的组成方式本身就是一等优化对象。 prefill 与 decode 的利用率曲线看似互斥,chunked-prefills 把前者切成饱和且均匀的计算单元,decode-maximal batching 让后者以 1.2ms 对 12.49ms 的边际成本随车执行;同一设计在流水线部署中把微批执行时间的方差抹平,bubble 减少 6.29x。
它改变的是看待推理调度的视角:吞吐与解码效率不必是两批请求之间的取舍。 chunked prefill 如今已是 vLLM 等主流引擎的默认行为,而搭车思想的完整形态——在保住吞吐的同时稳住 token 间隔——由后续的 Sarathi-Serve(OSDI 2024)完成。今天设计推理系统时值得沿用的问题由此变成:"每一批计算,是恰好均匀,还是被请求的到达顺序随机决定?"
Resources
Citation
@misc{agrawal2023sarathi,
  title         = {SARATHI: Efficient LLM Inference by Piggybacking Decodes with Chunked Prefills},
  author        = {Amey Agrawal and Ashish Panwar and Jayashree Mohan and Nipun Kwatra and Bhargav S. Gulavani and Ramachandran Ramjee},
  year          = {2023},
  eprint        = {2308.16369},
  archivePrefix = {arXiv},
  primaryClass  = {cs.LG}
}