
DFlash 2:正确 token 已在候选里,选一条连贯的路就好
Inco AI · 官方技术博客,2026-08-18
与前作不同,DFlash 2 目前没有论文,官方载体是 Inco AI 的技术博客(自称 sneak peek);本文按博客原文核对数据,引用格式也依博客给出的 BibTeX。文中所有增益均为博客报告值,未经过同行评审。
DFlash 已经解决了“猜得慢”:整块候选一次前向并行产出。但它没解决“猜得散”——每个位置独立取 top-1,相邻 token 互不通气,一个不连贯的块会在验证处被提前截断;而块内准确率还随位置后移持续衰减,越往后的候选越浪费。要修这两处,最直观的答案是 DSpark 那样的顺序修正头,或者把 drafter 整体加深,两者都要付出可观的参数与延迟代价。
DFlash 2 的回答是:两处问题的修法都比看上去便宜。它在不改 one-pass 起草的前提下加了两个小模块——一个在既有 top-16 候选中为整块选出一条连贯路径的 selector,一个混合相邻位置表示的两抽头动态卷积——合计只增加约 1.3% 的 draft-verify cycle latency。博客报告,每轮验证的产出提高 16%-25%;随 Qwen3.8-27B drafter 一同发布的 serving 结果中,SGLang 吞吐达到自回归解码的 2.7-3.4x(Muse Glimmer 上 3.1-4.6x),输出经 rejection sampling 保持无损。
Quick Start
截至 2026-09-23,DFlash 2 已进入 SGLang、vLLM、llama.cpp、Ollama 与 oMLX。生产路径以博客给出的 SGLang 启动命令为准(依据官方文档核对,未在本文环境实测):
pip install "sglang[all] @ git+https://github.com/sgl-project/sglang.git#subdirectory=python"

python -m sglang.launch_server \
  --model-path Qwen/Qwen3.8-27B \
  --speculative-algorithm DFLASH \
  --speculative-draft-model-path incoai/Qwen3.8-27B-DFlash2 \
  --speculative-num-draft-tokens 8
本地探索可走 z-lab 仓库的 dflash CLI:pip install "dflash[local]" 后用 MLX 后端运行 Qwen3.8-27B(博客发布后官方又新增了 GLM-5.3 的 DFlash 2 drafter,见 incoai 组织主页)。
一个容易踩坑的细节:博客命令使用 incoai/ 前缀的模型 ID,z-lab 仓库 README 则列出 z-lab/Qwen3.8-27B-DFlash2——两个组织目前都托管着同名 checkpoint,HuggingFace 上均可解析;写作时以你所用引擎文档给出的前缀为准。
Why DFlash 2?
DFlash 的起草器对每个位置独立预测,每一格各自选最可能的 token。单独看每格都合理,拼起来却可能不成句——博客给了一个直观的失败样例:相邻两个位置各自认为 “decoding” 最可能,于是块里出现重复的 stutter,整段在验证处被截断。并行起草省下的时间,被后缀的误判一点点吐回去。
这类不连贯有多严重?博客用一个诊断实验把问题拆开了:在 Qwen3-4B 的五层 DFlash 上逐位置统计,条件于此前位置全部正确。第一个位置 top-1 命中率 85.4%,但正确 token 落在前 16 个候选里的比例是 99.5%;即使走到块尾,Recall@16 仍有 87.8%。一个总能从 top-16 里选对的 oracle,能把接受长度从 4.27 拉到 6.79——这 2.5 个 token 的差距不缺信息,缺的只是选择。
| 位置 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 接受长度 |
|---|---|---|---|---|---|---|---|---|
| Recall@1 | 85.4% | 80.3% | 79.4% | 78.3% | 77.5% | 75.9% | 72.9% | 4.27 |
| Recall@16(oracle) | 99.5% | 97.3% | 94.8% | 92.6% | 90.8% | 89.4% | 87.8% | 6.79 |
来源:根据原博客 Table 1 重绘。五层 Qwen3-4B DFlash,GSM8K;接受长度含 verifier 的 bonus token。读表重点:两行之间的差距就是“选择余量”,且它在整个块内始终存在。
修法似乎现成:DSpark 和 Domino 用顺序头逐位重写分布,买回连贯性。但这是用自回归的成本换的——博客的对照实现中,DSpark 式修正给 drafter 增加 77.8M 参数和 9.6% 的 cycle latency。另一条路是加深 backbone:十五层 drafter 确实能缓解衰减,但十层额外的注意力块均匀花在所有位置上,连本就没什么提升空间的前段也不例外,代价是 15.2% 的 cycle latency。
问题因此变成两个具体的取舍:连贯性必须靠自回归修正买吗?后缀衰减必须靠整体加深修吗?
How DFlash 2 Works
洞察一:选择比预测便宜
DFlash 自己的候选列表里已经躺着正确答案,只是 top-1 没选它。DFlash 2 因此把“生成”和“挑选”分开:drafter 照旧一次前向产出每个位置的分布,selector 保留各位置 top-16 候选,对所有相邻位置逐对打分:
打分全程并行:所有位置的所有相邻对一次算完,没有额外 backbone 前向,也没有 LM head 调用。唯一的串行工作是对预计算分数的一次走查——greedy 沿最优后继走,sampling 从同一分数分布采样,最后经 rejection sampling 恢复 target 分布。
效果对照 DSpark 式修正(五层 Qwen3-4B,GSM8K,根据原博客 Table 2 重绘):
| 方法 | 新增参数 | cycle latency 开销 | τ(T=0) | τ(T=1) |
|---|---|---|---|---|
| DFlash | — | — | 4.27 | 3.78 |
| + DSpark 式修正 | +77.8M | +9.6% | 4.49 | 4.08 |
| + path selection | +2.0M | +0.6% | 4.61 | 4.25 |
选择器以约 1/40 的参数、1/16 的延迟开销,超过了重写分布的修正头。距离 oracle 的 6.79 仍有余量,博客也承认两两打分只是最简单的 selector。
洞察二:后缀衰减是局部问题
Selector 修不了另一件事。上面 Table 1 里连 oracle 都在衰减——候选本身在块尾“变差”了。博客称之为 suffix decay,并确认它是 backbone 的问题:三、五、十五层 drafter 在第一个位置的命中率几乎相同,随位置后移才逐渐拉开,说明加深确实有效,只是打错了地方。
注意力统计指出了该打哪里。DFlash 的注意力承担两件事:读块前上下文,以及建模块内依赖;但后者占比从第 1 层的 30% 一路降到第 5 层的 8%,且越来越集中在少数几个头里。也就是说,块内依赖是短程的、局部的——一个块只有 4-16 个 token,最紧的依赖就在相邻位置之间——却让全量注意力背着。
DFlash 2 因此把块内工作交给一个专用算子:两抽头动态深度卷积,插在每层注意力与 FFN 子层的前后:
每个位置混合自己与前一个位置的表示,系数由“基础核 + 从当前隐状态算出的小修正”自适应生成(每 16 个通道共享一个修正);块首位置读取的是上一个已验证 token 的表示。信息穿过整块,而所有位置仍然并行计算。
这个模块是块内局部且无状态的,直接嵌入 DFlash 而不动注意力、LM head 和验证流程。代价与收益的对比很直接:仅增加 16.5M 参数(3%)和 0.7% 的 cycle latency,五层 + 卷积在块尾的命中率已接近十五层 drafter;第 4、5 层的平均块内注意力占比从 9.4% 降到 0.5%,说明卷积确实接走了局部工作,注意力回到读上下文本职。一个只回看一个位置的核,拿回了十层 Transformer 大部分买到的东西。
设计
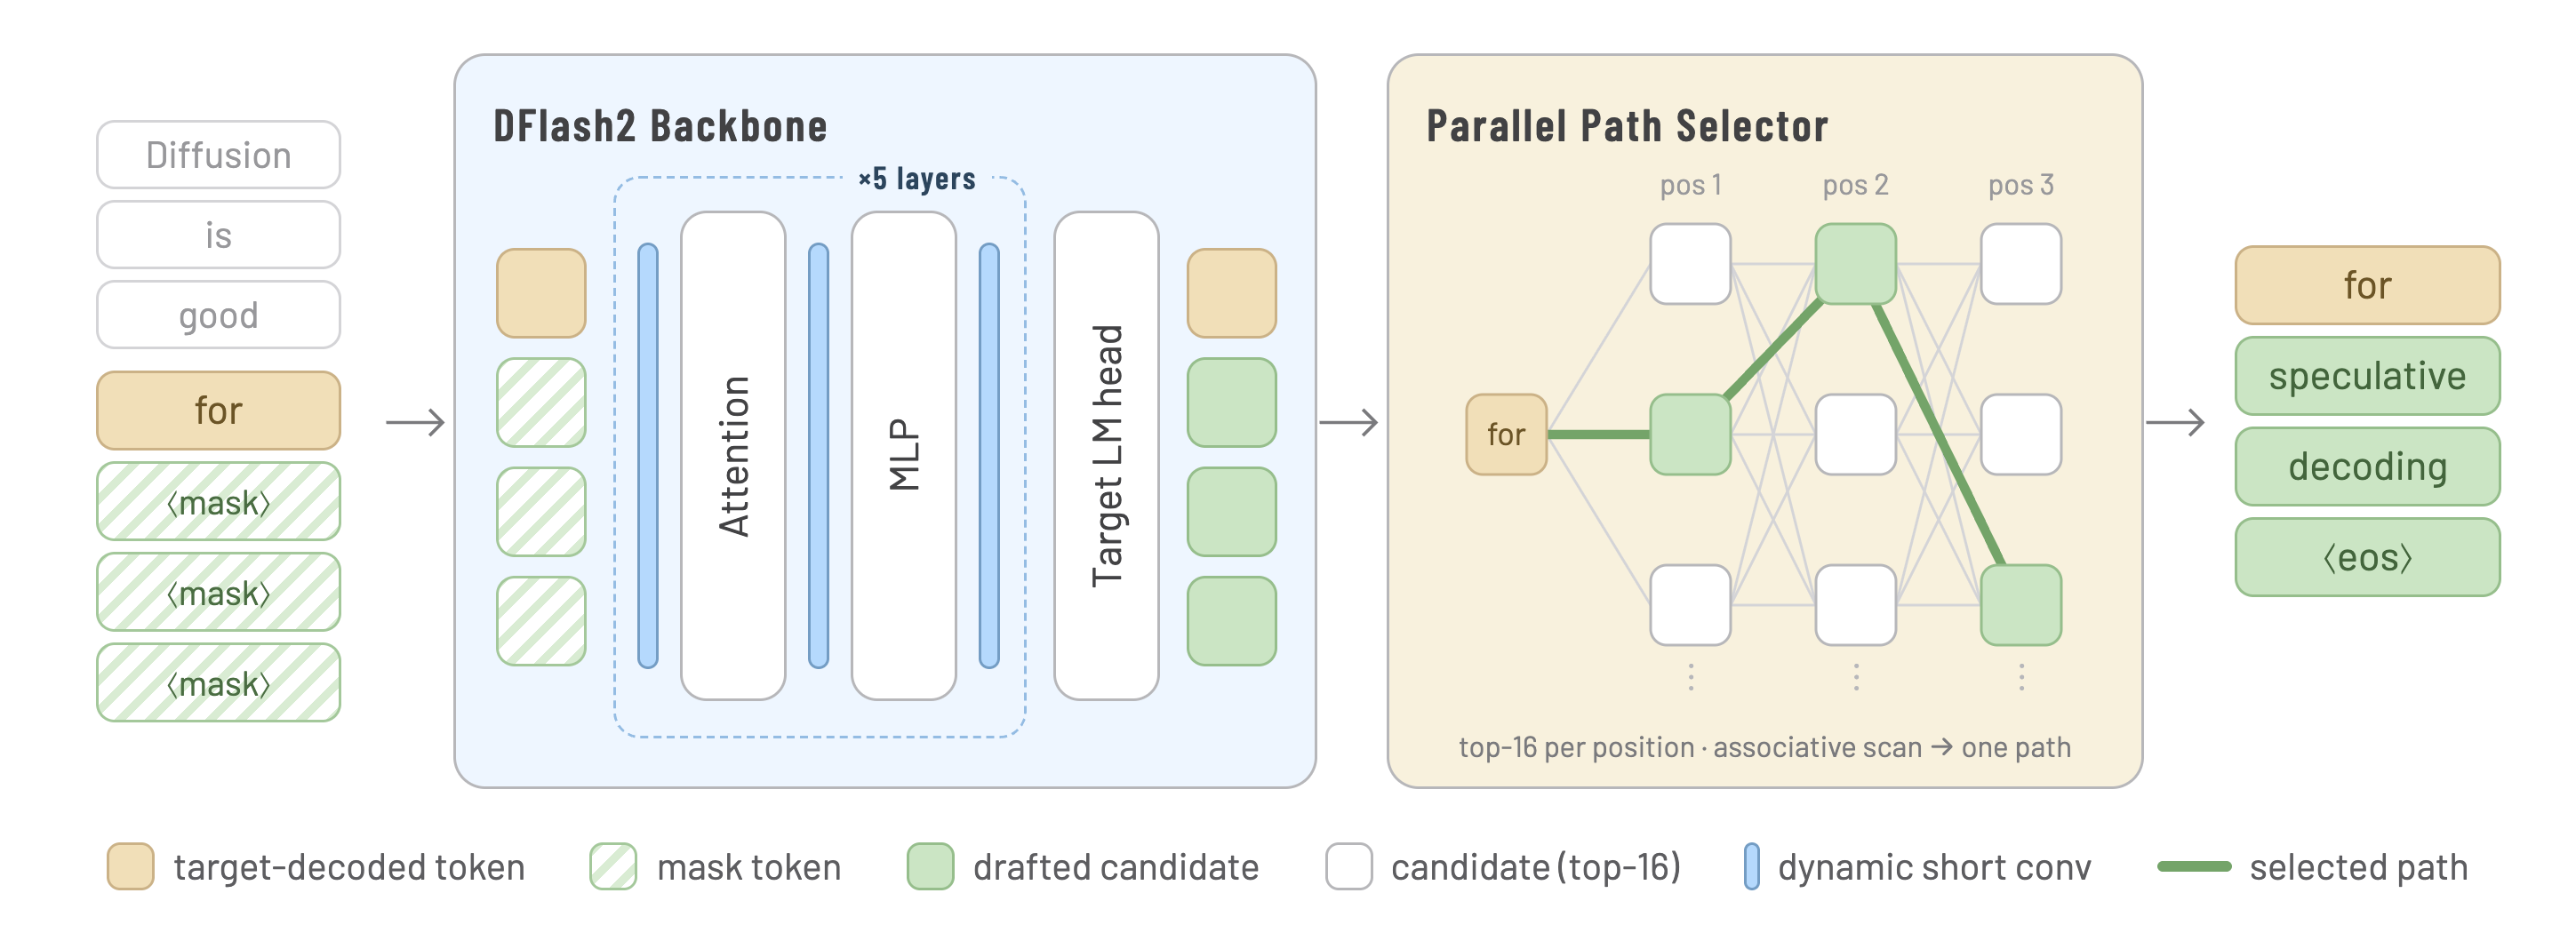
来源:官方仓库 README 引用的 DFlash 2 架构图。读图重点:selector 与卷积都不改变 one-pass 起草与验证接口,两个模块叠加后 cycle latency 总开销为 1.3%。
Results
博客的主对比在 Qwen3.5-4B 上进行,采样设置与 DFlash 一文不同:thinking 开启,temperature 1.0、top-p 0.95、top-k 20、presence penalty 1.5,并使用无损 rejection sampling。四个方法中 MTP 随模型发布,DFlash 与 DSpark 的 drafter 由博客作者在匹配设置下自行训练(根据原博客 Table 3 重绘):
| 数据集 | MTP | DFlash | DSpark | DFlash 2 |
|---|---|---|---|---|
| GSM8K | 4.78 | 4.99 | 5.69 | 6.20 |
| MATH-500 | 5.04 | 5.42 | 6.20 | 6.76 |
| HumanEval | 4.84 | 5.43 | 5.80 | 6.28 |
| MBPP | 4.16 | 4.49 | 4.96 | 5.41 |
| MT-Bench | 3.90 | 4.26 | 4.77 | 5.20 |
| 平均 | 4.54 | 4.92 | 5.49 | 5.97 |
数值为每请求平均接受长度
逐位置看更能说明改进的结构。MATH-500 上,DFlash 的条件接受率在块尾跌回 77.5%,DSpark 跌到 79.9%,而 DFlash 2 到最后一个位置仍保持 86.5%——它不是开局更准,而是把准确率守到了块尾(根据原博客 Figure 5 节选重绘):
| 位置 | 0 | 3 | 7 | 11 | 13 | 14 |
|---|---|---|---|---|---|---|
| MTP | 84.6% | 78.4% | 77.7% | 77.4% | 77.5% | 77.9% |
| DFlash | 88.4% | 79.5% | 81.1% | 80.3% | 78.8% | 77.5% |
| DSpark | 87.2% | 83.6% | 83.0% | 80.7% | 80.6% | 79.9% |
| DFlash 2 | 88.3% | 84.9% | 85.1% | 86.5% | 86.0% | 86.5% |
随博客一同发布的两个 drafter 给出了产品规模的数字。Qwen3.8-27B(block size 8,模型默认采样):平均
这份证据有两处需要克制的边界。其一,这是一篇厂商博客而非论文:DFlash 2 与 DFlash、MTP 的对比虽声明了匹配设置,但 DSpark drafter 是作者自训的,与 DSpark 论文自己报告的 +16.3%-18.4% 相对 DFlash 提升来自不同模型、不同 block size 与不同数据,两组数字不能互相印证或相乘;两个团队对“谁更准”的表述也各执一词,读者应当把双方都视为带立场的报告。其二,selector 的两两打分只建模相邻依赖,离 6.79 的 oracle 上限仍有约 1.8 个 token 的余量,更长的依赖结构是否需要更宽的打分窗口,博客留作开放问题。
Conclusion
DFlash 2 证明了并行起草的下一步不在 backbone:先把候选选对、再把局部依赖接上,就能在不放弃 one-pass 的前提下每轮多赚一个 token。 Selector 用 2M 参数兑现了 Recall@16 与 Recall@1 之间 2.5 个 token 的选择余量,两抽头卷积用 3% 参数把 suffix decay 压到与加深三倍参数相当的水平,而验证接口与无损性原封未动。
更值得记住的是它给出的一套诊断框架:用 Recall@k 把“猜不中”拆成“候选里没有”与“没有选对”,再对症下药。 前者要动生成模型,后者只需要便宜的选择算子——这个分解适用于任何并行 drafter,也把“自回归修正是否必要”变成了一个可以量化回答的问题。博客自陈这只是其 serving 栈的第一块拼图,selector 与卷积的组合上限、以及两家厂商结论的独立复现,都还要等下一步证据。
Sources
- DFlash 2: Keep Drafting Parallel(Inco AI 官方博客),2026-08-18 发布,本文于 2026-09-23 核对;本文全部数据取自该文
- Official DFlash repository,用于核对 2026-09-23 的引擎支持与 checkpoint 列表
- DFlash 2 model collection,吞吐明细见 Qwen3.8-27B 与 Muse Glimmer 的模型卡
- 本站相关阅读:DFlash:drafter 的答案,早写在 target model 的隐层里 · DSpark:既要猜得连贯,也要把验证算力花在刀刃上
Citation
@misc{inco2026dflash2,
  title  = {DFlash 2: Keep Drafting Parallel},
  author = {{Inco AI}},
  year   = {2026},
  month  = {August},
  url    = {https://inco.ai/blog/dflash2/}
}