
DFlash:drafter 的答案,早写在 target model 的隐层里
Jian Chen, Yesheng Liang, Zhijian Liu · ICML 2026
Paper · Code · Models · Project page
大语言模型的推理是一条串行链:每个 token 都要等前一个生成完。Speculative decoding 是目前主流的无损加速方案——让一个小 draft model 先猜一段候选 token,再由 target model 一次并行验证——但包括最强方法 EAGLE-3 在内,现有方法的“猜”本身仍是自回归的,逐 token 起草的延迟把实际加速压在约 2-3x。
DFlash 把起草这一步整个交给一个轻量 block diffusion model:它在单次前向中并行预测一整块 token,同时读取 target model 已经算出的多层 hidden features 作为条件。论文在 Qwen3-4B/8B 非思考模式的七项数学、代码与对话任务上报告平均 4.9x 的自回归 baseline 加速(greedy decoding,Transformers 后端,H200),相对同等 drafting budget 的 EAGLE-3 平均提高 2.4x,单项最高 6.09x;输出分布仍由 speculative verification 决定,保持 lossless。
Quick Start
截至 2026-09-23,官方仓库同时承载两代工作:本文解读的 ICML 2026 论文 DFlash,以及其后续 DFlash 2(新增 Muse-Glimmer-30B、Qwen3.8-27B 等 checkpoint,见官方博客)。下面只展示对应论文的 DFlash 路径,命令依据当前官方 README 核对,未在本文环境中下载模型或占用 GPU 实测。
本地探索走 Transformers(Linux)或 MLX(Apple Silicon),Transformers 后端支持 Qwen3 系列与 LLaMA-3.1-8B 的 DFlash checkpoint:
pip install "dflash[local]"

dflash generate transformers \
  --model Qwen/Qwen3-8B \
  --draft z-lab/Qwen3-8B-DFlash-b16 \
  "How many positive whole-number divisors does 196 have?"
生产集成走 OpenAI-compatible server:单独启动带 DFlash 支持的 SGLang 或 vLLM 服务,再通过 dflash generate openai --base-url http://127.0.0.1:8000 --model <target> 调用。serving 后端的版本要求变化较快,应以官方仓库当前说明为准。
Why DFlash?
Speculative decoding 的分工很清楚:draft model 每轮提出
加速只有两个杠杆:把
自回归 drafter 在这两个杠杆之间互相牵制。每多猜一个 token 就多一次串行前向,
Diffusion 看起来是天然的并行起草器,但直接替换已经被反复证明不够。一条路是“大而准”:DiffuSpec、SpecDiff-2 使用约 7B 参数的 drafter,显存与起草延迟都很高,实际加速停在 3-4x。另一条路是“小而快”:PARD 这类小型并行 drafter 的容量不足,上限约 3x。DFlash 论文还补了一个更干净的反例——一个不读取任何 target 信息、只有五层的 block diffusion drafter,在 Qwen3-4B 的四个数学任务上加速只有 2.65x-3.73x。没有 target 的内部知识,再并行的 drafter 也只能从零猜起。
问题由此收敛成一个具体的形态:能否让 diffusion drafter 同时足够小、足够快,又足够准?
How DFlash Works
关键洞察:答案的线索已经在 target model 里
论文的判断很直接:the target knows best。Target model 在 prefill 或上一轮验证结束时,除了下一个 token 的 logits,还留下多层 hidden features;此前的工作(Samragh et al.)已经观察到,这些特征隐含了关于多个未来 token 的信息。与其让一个小模型从零推理,不如让它读取这些已经算好的上下文——起草任务就从“独立预测”变成了“沿着 target 的思路快速补全”。
这也重新定位了 diffusion model 的角色:它不需要在端到端生成质量上击败 autoregressive LLM,只需要成为一个快而准、最终会被验证的 block drafter。
为什么 diffusion 改变了权衡公式
回到上面的延迟公式,两个 drafter 范式在
自回归起草的成本随候选数线性增长;block diffusion 在一次前向中同时解出整块 masked positions,成本对 token 数基本不敏感。于是“加深 drafter”不再是延迟禁区:多出来的层只会提高
论文用 Figure 3 给出了直接证据:五层 DFlash 一次起草 16 个 token 的延迟,仍低于单层 EAGLE-3 起草 8 个 token。更深、猜得更多,用时反而更少——这正是 EAGLE-3 做不到的组合。
设计
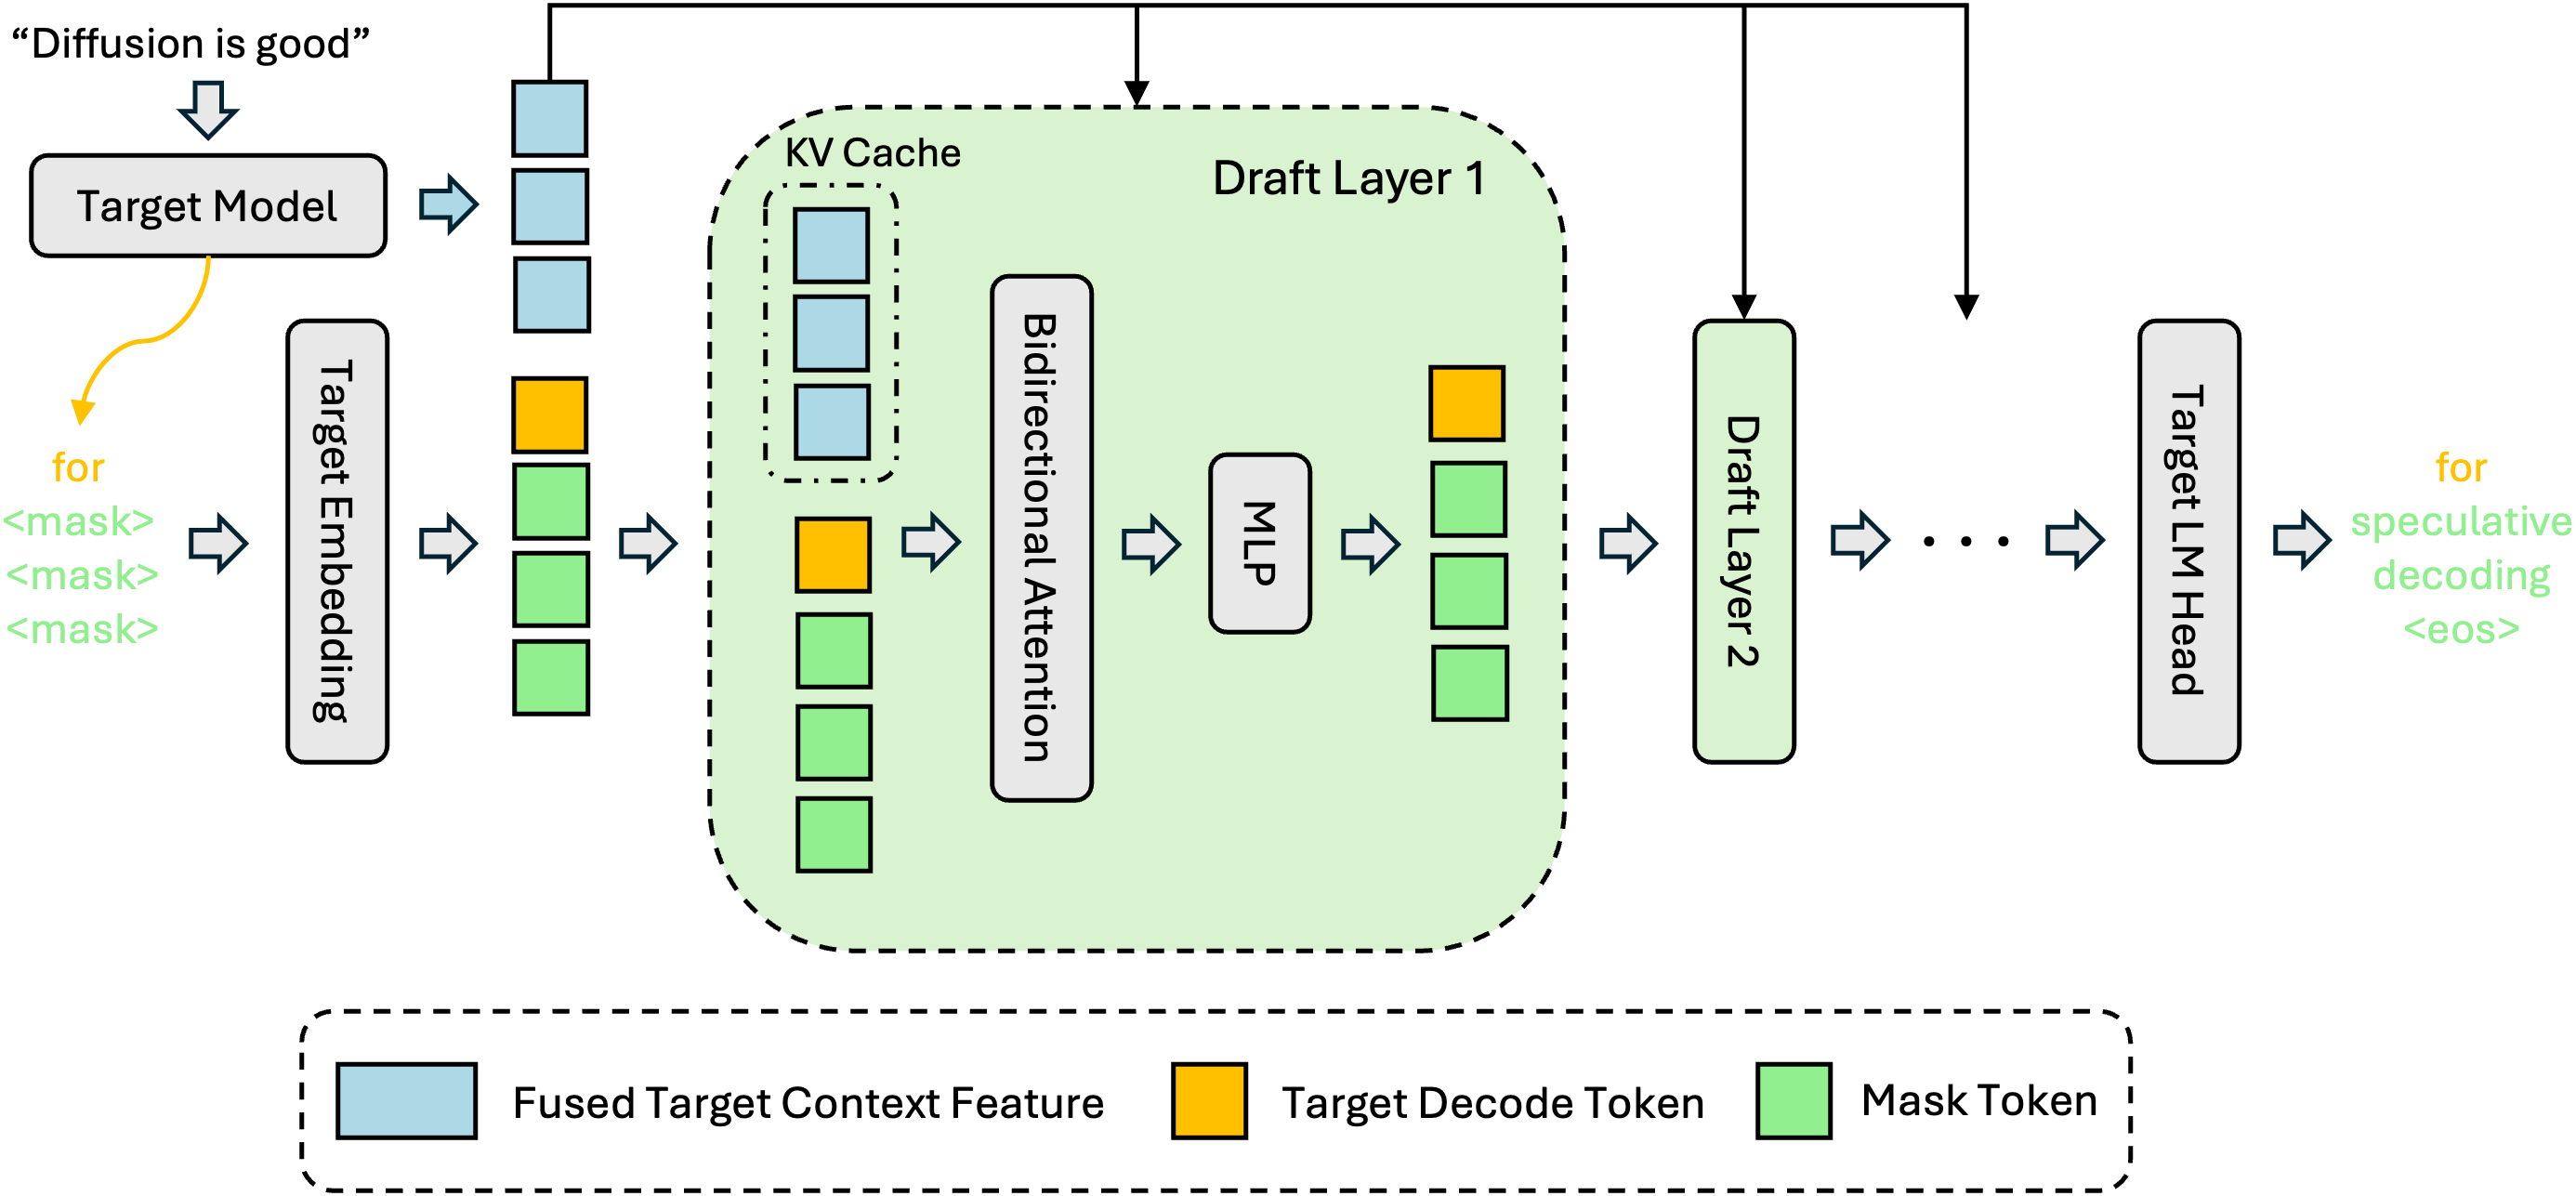
来源:DFlash 官方项目页,对应论文 Figure 2。读图重点:target context 不是只在 drafter 入口出现一次,而是进入每一层的 Key/Value;这保证了“加深 drafter”时信号不被稀释。
- Feature Fusion: 从 target model 由浅到深均匀抽取五个层的 hidden features(第 2 层到倒数第 3 层之间),拼接后经一个轻量 projection 压缩成紧凑的 target context feature。
- KV Injection: 把融合特征直接投影到每一层 drafter 的 Key/Value,存入 KV cache 并跨起草迭代复用。这与 EAGLE-3 的 input fusion 有本质区别:后者只在第一层输入端注入 target feature,层数加深后信号逐渐稀释;逐层注入让
能随深度持续增长。 - Parallel Drafting: Drafter 以最后一个已验证 token 和持久 target context 为条件,用单步 block diffusion 一次并行预测下一块 token,再交给 target model 验证。
训练围绕同一个推理接口展开。DFlash 复用 target 的 embedding 与 LM head,只训练中间几层,参数量极小。构造训练块时随机采样 anchor token 作为块首并遮住其余位置,与推理时“永远从 target 给出的 bonus token 起草”的行为对齐;多个块拼进一条序列,用稀疏注意力在单次 forward/backward 中联合训练,块与块之间互不可见以防止信息泄漏。训练数据约 800K 条,取自 NVIDIA Nemotron Post-Training Dataset V2 与 CodeAlpaca,且全部使用 target model 自己生成的回复以强化对齐。
Results
比较在公平预算下进行:Qwen3-4B/8B、LLaMA-3.1-8B 等模型,数学(GSM8K、MATH-500、AIME25)、代码(HumanEval、MBPP、LiveCodeBench)与对话(MT-Bench)任务;Transformers 主实验在 NVIDIA H200 上运行。DFlash 使用 block size 16 与单步去噪;EAGLE-3 同时报告 tree size 16(与 DFlash 对齐 drafting budget)和 60(原论文设置,draft steps 7、top-k 10),Qwen3 使用 AngelSlim 发布的 checkpoint。

来源:原论文 v2 Figure 1。读图重点:在 Qwen3-8B 与 Transformers 设置中,DFlash 的端到端加速在所有任务上高于 EAGLE-3;对话任务(MT-Bench)收益明显小于数学与代码,说明开放式生成的接受长度更难做高。此图不覆盖其他模型、硬件或 serving 后端。
以 Qwen3-8B、greedy decoding 为例(根据原论文 Table 1 重绘):
| 任务 | EAGLE-3 (16) | EAGLE-3 (60) | DFlash (16) |
|---|---|---|---|
| GSM8K | 1.94x / 3.23 | 2.23x / 3.71 | 5.15x / 6.54 |
| MATH-500 | 1.81x / 3.02 | 2.05x / 3.49 | 6.08x / 7.87 |
| HumanEval | 1.89x / 3.17 | 2.17x / 3.65 | 5.14x / 6.50 |
| LiveCodeBench | 1.57x / 2.65 | 1.81x / 3.03 | 5.51x / 7.27 |
| MT-Bench | 1.63x / 2.83 | 1.90x / 3.26 | 2.75x / 4.24 |
| 七任务平均 | 1.76x / 2.96 | 2.02x / 3.40 | 4.86x / 6.49 |
数值为相对自回归 baseline 的端到端加速 / 平均接受长度
两个消融把增益拆开归因。其一是条件注入方式(Qwen3-4B,五层 drafter,block size 8):把 target features 从仅输入第一层改为逐层 KV 注入,GSM8K 的
收益延伸到了 serving 场景,但数字不能横向拼接。单张 B200、SGLang 与 FlashAttention-4 后端下,concurrency 1-32 全程保持加速:Qwen3-8B 在 MATH-500、并发 1 时最高 5.1x,并发 32 收窄到 2.8x;Qwen3-Coder-30B-A3B 在高并发下仍维持约 3x。Thinking mode 下(GPQA、MATH-500、AIME25),加速约为 4.2x-4.6x(greedy)与 3.6x-4.0x(sampling)。附录还报告了 Qwen3.5 系列、GPT-OSS 等更多模型相对 native MTP 的优势,以及 vLLM 上的结果。
证据边界同样需要说清。论文没有与 DiffuSpec、SpecDiff-2 等其他 diffusion speculative decoding 方法做直接实验比较,理由是缺少开源实现,相关数字只能引各自的论文。Drafter 默认训练上下文为 4K,超出后接受长度明显下降(Qwen3.5-27B 在 16K 时
Conclusion
DFlash 证明了加速来自一次条件重分配:diffusion 不必承担回答质量,只需在 target 隐层特征的条件下快速补全整块候选。 逐层 KV injection 解决“小 drafter 猜不准”,单步并行起草解决“自回归起草慢”,speculative verification 兜底输出分布——三个环节分别对应延迟公式里的
更值得记住的是它对 diffusion LLM 的角色重构:与其训练巨型 dLLM 去追赶 autoregressive 质量,不如把它缩成受验证的并行 drafter。 论文在所测模型与系统上证实了这条分工;像 DSpark 这样的后续工作已经开始在 DFlash 的并行骨架上继续修补块内一致性,说明这条路线正在被社区接续推进。
Sources
- DFlash arXiv v2,2026-02-05 提交、2026-05-28 修订的 ICML 2026 版本,本文于 2026-09-23 核对
- Z Lab DFlash project page,用于核对方法图与单步去噪设置
- Official DFlash repository,用于核对 2026-09-23 的安装与使用入口,以及 DFlash 2 的发布状态
- Official model collection
- 本站相关阅读:DFlash 2:正确 token 已在候选里,选一条连贯的路就好 · DSpark:既要猜得连贯,也要把验证算力花在刀刃上
Citation
@inproceedings{chen2026dflash,
  title     = {DFlash: Block Diffusion for Flash Speculative Decoding},
  author    = {Chen, Jian and Liang, Yesheng and Liu, Zhijian},
  booktitle = {Proceedings of the 43rd International Conference on Machine Learning (ICML)},
  year      = {2026}
}