
显存层次与存储
存储系统的本质是矛盾:快的装不下,装得下的不快。
从寄存器到硬盘的金字塔
一块 GPU 服务器里,数据可以待在很多地方,越往上越快、越小、越贵:
| 层次 | 典型容量 | 典型带宽 | 距离计算单元 |
|---|---|---|---|
| 寄存器 | 每 SM 约 256 KB | 最高 | 就在计算单元旁边 |
| 共享内存 / L1 | 每 SM 数百 KB | 数十 TB/s | 片上 |
| L2 Cache | 约 50 MB | 数 TB/s | 片上 |
| HBM 显存 | 80~192 GB/卡 | 3~8 TB/s | 同封装 |
| 主机内存(DDR) | TB 级 | 数百 GB/s | 跨 PCIe |
| NVMe SSD | 数 TB | 10~50 GB/s | 跨 PCIe |
| 对象存储 / HDFS | PB 级 | 网络决定(GB/s 量级) | 跨集群 |
block-beta
    columns 1
    block:top:1
        A["寄存器/共享内存:KB 级,最快"]
    end
    block:s1:1
        B["L2 Cache:几十 MB"]
    end
    block:s2:1
        C["HBM 显存:几十 GB,TB/s 级带宽"]
    end
    block:s3:1
        D["主机内存:TB 级,数百 GB/s"]
    end
    block:bottom:1
        E["NVMe SSD / 对象存储:TB~PB 级,最慢"]
    end
存储金字塔:越往上越快越贵,越往下越大越慢。相邻两层带宽差 2~10 倍,容量差 10~100 倍。
每一层与上一层之间大约是 10 倍的容量、1~2 个数量级的带宽差距。AI Infra 的存储问题,几乎都是在回答同一件事:热点数据应该在金字塔的哪一层,怎么让它向上流动、用完再流回去。
训练时显存里装了什么
拿一个 7B 参数模型做笔算(BF16,每参数 2 字节):
| 内容 | 大小 | 说明 |
|---|---|---|
| 权重 | 14 GB | 前向反向都要读 |
| 梯度 | 14 GB | 反向传播产生 |
| 优化器状态(Adam) | 56 GB | FP32 的动量、方差与主权重副本 |
| 激活值 | 随 batch 和序列长度增长 | 反向传播要重读 |
参数只占 14 GB,优化器状态却是它的 4 倍——这是 Adam 类优化器的隐藏成本。用公式统一表达,混合精度 Adam 训练的静态显存为:
其中权重 BF16 占 2 字节/参数、梯度 2 字节/参数、优化器状态占 12 字节/参数(FP32 主权重 4 + 动量 4 + 方差 4)。代入 70B:
于是有了分而治之的 ZeRO 系列:把权重、梯度、优化器状态切分到多张卡上,每张卡只保存
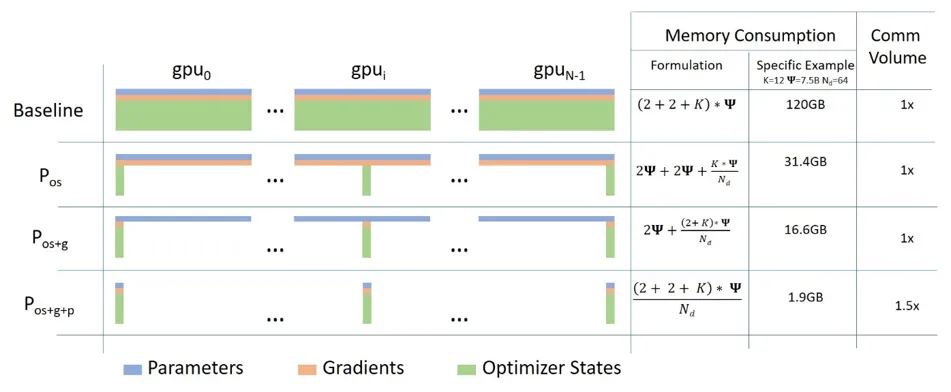
图源:Hugging Face 博客《ZeRO: The Memory Optimization Chronicle》(据 DeepSpeed ZeRO 论文)。通信量为切分后相对值。
切分解决"装不下",**卸载(offloading)**则更进一步:"我卡上不要了,放 CPU 内存/SSD 去,用到再取"。ZeRO-Infinity 甚至把优化器状态和参数都卸载到 CPU 内存与 NVMe,靠 NVMe 带宽换显存容量。代价是 PCIe(约 64 GB/s)远慢于 HBM,所以卸载通常配合计算重叠(边算边搬)来隐藏延迟——这正好呼应上一篇的结论:搬运是昂贵的,能不搬就不搬,必须搬就边算边搬。
深入推导:激活值显存与卸载可行性判据
激活值显存公式(Korthikanti et al., 2022,配合 Flash Attention 与序列并行):每个 Transformer 层的激活值约为
其中
ZeRO 通信量推导。普通数据并行每步对
卸载可行性判据。卸载到 CPU 的传输走 PCIe(
推理时的 KV Cache 与显存压力
推理没有梯度和优化器状态,但多了一样东西:KV Cache。为了不让每生成一个 token 就把全部历史重算一遍,注意力的历史状态必须驻留显存。它的精确公式:
其中因子 2 对应 K 与 V 两份,
一条 8K token 的请求就是约 4 GB。若改用 GQA(8 个 KV 头),直接降到 128 KB/token、8K 约 1 GB——这就是 GQA 成为标配的 Infra 原因。并发服务几十条 MHA 请求,KV Cache 就能把 80 GB 显存吃掉一大半——这也是后面 P/D 分离和 KV Cache 管理与卸载(如 Mooncake 把 KV Cache 放到 CPU 内存甚至远端节点)的动因。
数据集与 Checkpoint:金字塔的底部
- 训练数据:万亿 token 的数据集以 TB 计,只能放在对象存储/HDFS,训练时由数据加载器流式读入。流水线任何一段跟不上,GPU 就会"断粮"。
- Checkpoint:万卡集群每几分钟就要把训练状态快照一次,一个万卡训练的完整 checkpoint 轻松超过 10 TB。写入时间
:40 TB 状态写到 TB/s 级存储也要约 40 s,写入太慢则拖住训练,恢复太慢则白白烧掉昂贵的集群时间(容错与 Checkpoint篇推导最优间隔,Checkpoint 存储与加载篇讲怎么写快)。DeepSeek 为此自研了 3FS 文件系统,用多机并发把 checkpoint 写入做到 TB/s 级。
小结
- 存储金字塔每层差 1~2 个数量级带宽、10 倍以上容量,热点数据要尽量靠近计算单元。
- 训练显存大头往往不是参数而是优化器状态;ZeRO 切分 + 卸载是标准解法。
- 推理的显存大项是 KV Cache,它随并发与序列长度线性增长。
- 数据集流式加载与 checkpoint 快写快恢复,是集群规模下存储的两大刚需。
思考题
- 一个 175B 模型用混合精度 Adam 训练,静态显存是多少?8 张 80 GB 的卡用 ZeRO-3 能装下吗(忽略激活值)?
- 模型
、 、 (GQA),FP16:一条 32K token 的请求 KV Cache 多大? - 全量重算把激活值显存降到
/层,代价是计算量增加多少百分比?什么情况下值得交换?
参考答案
;ZeRO-3 切到 8 卡后每卡 ,仍超过 80 GB——ZeRO-3 只切参数相关状态,总显存不变,是均摊不是压缩,装不下就必须叠加卸载或更多卡。 。长上下文下 KV Cache 轻松超过权重读取成本,这是长文本推理贵的原因。 - 额外一次前向
,占总计算量 的约 33%。当显存不足导致必须减小 batch 或序列长、且这带来的 MFU 损失超过 33% 时才值得——实践中全量重算很少用,选择性重算(只重算计算便宜的部分)更常见。
参考资料
- Rajbhandari et al., ZeRO: Memory Optimizations Toward Training Trillion Parameter Models(arXiv 1910.02054)
- Rajbhandari et al., ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning(arXiv 2104.07458)
- Korthikanti et al., Reducing Activation Recomputation in Large Transformer Models(arXiv 2205.05198)
- Hugging Face,ZeRO: The Memory Optimization Chronicle
- DeepSeek,3FS - Fire-Flyer File System(GitHub)