
投机采样
小模型起草、大模型验卷。让带宽受限的大模型 decode 一次输出多个 token,且输出分布严格不变。
解码的结构性浪费
decode 每步读全部权重(带宽受限),却只产出 1 个 token、只做 1 次"轻"计算——算力侧大量闲置。投机采样的洞察:用一次大模型前向验证多个候选 token,接受的候选"免费"产出。
机制:起草-验证-接受
- 起草:小模型(如 1B)自回归快速生成
个候选 token(每个只花小模型的毫秒级时间); - 验证:大模型一次前向并行处理这
个候选,得到每个位置的分布; - 接受:从左到右逐一接受;标准拒绝采样保证输出分布与大模型直接采样严格一致:
拒绝处用残差分布重采样一个修正 token,随后候选作废、回到起草; - 产出:每轮接受
个 token(含修正 token)。
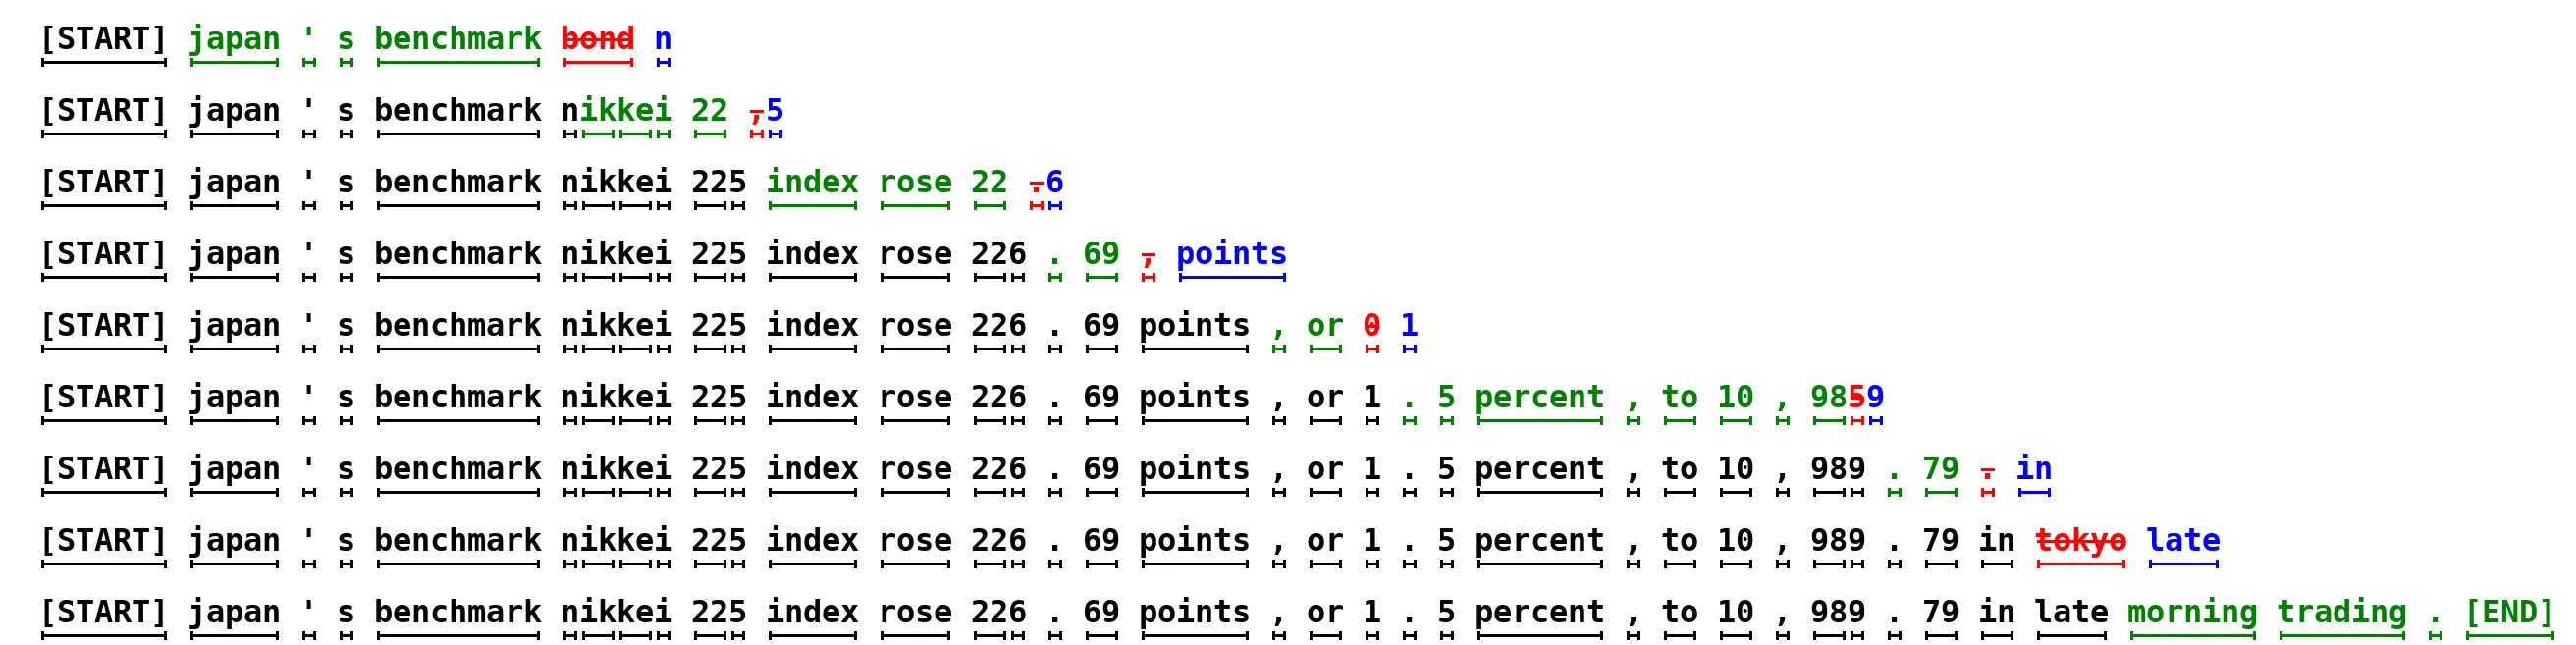
图源:Leviathan et al. 2023(arXiv 2211.17192)。
收益账
加速比:
变体谱系
| 变体 | 草稿来源 | 特点 |
|---|---|---|
| 经典双模型 | 独立小模型 | 需维护两个模型、KV 分离 |
| 自投机 / Medusa | 大模型自身的多头 | 无需小模型,多头预测 |
| EAGLE | 大模型特征层的轻量头 | 接受率高(草稿看得见大模型内部状态) |
| Tree 投机 | 候选组织成树 | 一次验证多条路径,接受率再升 |
| N-gram / look-ahead | 重复模式推测 | 零模型成本,适合结构化文本(代码) |
深入推导:接受-拒绝流程为何严格保分布,及收益边界
保分布证明。目标分布
展开可验证逐点等于
收益上界与倒挂条件。
与 Continuous batching 的交互。批内多请求时,验证迭代仍是"权重读一遍、batch 维度并行",投机收益在 batch 大时被稀释(带宽本已摊薄)——投机采样是低并发场景的延迟优化,满载服务下收益趋零甚至负(这也是 vLLM 默认不开启、按请求动态启用的原因)。
(据 Leviathan & Kalman 2023、Cai et al. 2024 Medusa、Li et al. 2024 EAGLE。)
思考题
、 :每轮期望产出几个 token?理想加速比是多少(忽略草稿开销)? - 为什么代码任务适合 N-gram 投机而开放域聊天更适合 EAGLE?
- 高并发满载服务要不要开投机采样?决策依据是什么?
参考答案
token/轮;理想加速 2.95 倍——但实际还要扣小模型起草时间与验证的额外算力,约 2~2.5 倍。 - 代码充满重复模式(变量名、缩进、模板结构),N-gram 零成本命中率高;开放域草稿分布复杂,需要 EAGLE 式"看得到大模型内部状态"的草稿器才能维持高
。 - 用 batch 饱和分析:decode 已在带宽饱和点(
)时,验证多算的 倍 token 仍要占同一带宽,收益归零;且草稿模型挤占显存。只在低并发、延迟敏感(TPOT 主导体验)时开启。
小结
- 投机采样 = 草稿 + 并行验证 + 统计保真的接受-拒绝,输出分布严格等于大模型。
- 收益
,一切系于接受率 ;任务相关,需自适应开关。 - Medusa/EAGLE 把草稿器做大模型自己的"斜杠器官",N-gram 是零成本的代码特化。
- 定位:低并发延迟优化;高并发满载时让位给 continuous batching。
参考资料
- Leviathan & Kalman, Fast Inference from Transformers via Speculative Decoding(arXiv 2211.17192)
- Chen et al., Accelerating LLM Decoding with Speculative Sampling(arXiv 2302.01318)
- Cai et al., Medusa: Simple LLM Inference Acceleration Framework with Multiple Decoding Heads(arXiv 2401.10774)
- Li et al., EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty(arXiv 2401.15077)
- Liu et al., Online Speculative Decoding(arXiv 2310.07177,按查询分布自适应)