
KV Cache
推理系统里最重要的一个数据结构。显存带宽是芯片给的,KV Cache 是你自己花掉的。
为什么必须缓存
自回归生成每个 token 时,注意力的
显存账
显存层次篇的公式:
代入 Llama-2-7B(
碎片与浪费:为什么需要 PagedAttention
传统实现按"最大长度"预分配连续显存,实测利用率常低于 40%:
- 预留浪费:按 max_length 分配,实际只生成了一半;
- 外部碎片:请求长短不一,释放后留下 hole;
- 内部碎片:固定块内未填满。
vLLM 的 PagedAttention 借用操作系统虚拟内存的思想:KV Cache 切成固定大小的块(block,如 16 token/块),用块表(block table)维护逻辑→物理映射,按需分配:
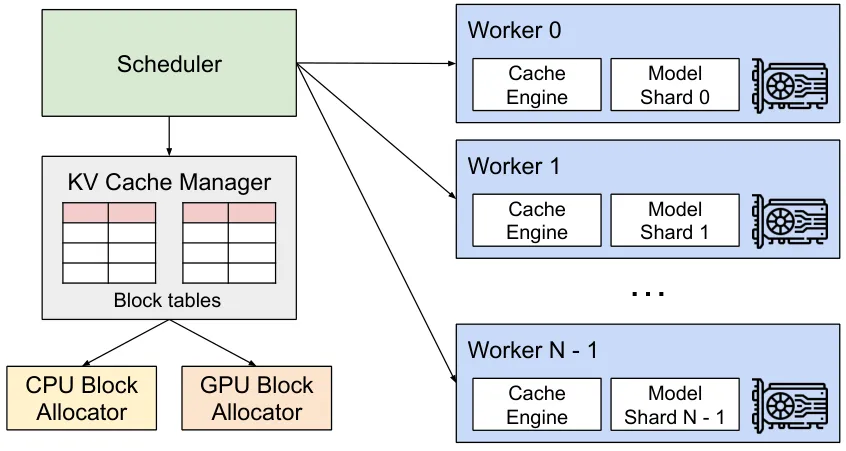
图源:vLLM 论文(arXiv 2309.06180)。
效果:显存浪费从 60~80% 降到 4% 以下,同卡并发数翻倍以上——吞吐提升不是来自算得快,而是来自装得多。
GQA 与 MLA:从结构上压 KV
- GQA(分组查询注意力):
个 KV 头共享给 个查询头,KV 直接除以组数(7B 从 0.5 MB/token 降到 128 KB/token); - MLA(DeepSeek 多头潜在注意力):把 KV 压缩到低秩潜在向量(每 token 576 维),比 MHA 省一个数量级,且配合前缀缓存友好。
结构级压缩(改模型)永远比系统级腾挪(改服务)收益大——但改结构要重训,两者是工程光谱的两端。
深入推导:decode 的 roofline 修正——KV 读取项
芯片架构篇的 decode 下限只算了权重读取:
代入 70B(GQA 8 头、
Page 大小的权衡。块越小碎片越少,但块表查询与 kernel 访存越细碎(gather 访问丧失连续性);vLLM 取 16 token/块,实测碎片 <4% 且访存效率损失可忽略。
(据 Kwon et al. 2023、Ainslie et al. 2023 GQA。)
思考题
- 32B 模型(
、GQA 8、 、FP16):一条 16K 请求的 KV 多大?80 GB 卡、权重 64 GB,还剩多少并发空间? - 为什么"按最大长度预分配"在共享型服务里浪费尤其严重?
- MLA 压缩 KV 为什么比 GQA 更激进?它的代价是什么?
参考答案
/请求;剩余 16 GB → 约 3.7 条并发(还要留激活),并发空间极小——权重吃掉大头时 KV 空间就是稀缺品。 - 共享服务请求长度方差极大(有人问一句、有人贴一篇论文):按 max 预留时,短请求的预留全变浪费;方差越大、利用率越低。
- GQA 只减少 KV 头数(组数下限约束),MLA 把 K/V 联合投影到低秩子空间(秩 512 级),压缩率更高且不损失注意力表达能力(理论可恢复)。代价:训练结构改变需重训、吸收矩阵计算使 prefill 计算量上升、实现复杂度高。
小结
- KV Cache 使生成从
降到 ,但其动态增长的显存是服务的核心约束。 - PagedAttention 用分页思想消灭碎片,把"吞吐"问题转化为"装得多"问题。
- GQA/MLA 从模型结构压缩 KV,收益大于一切系统优化。
- 长上下文大并发下,KV 读取反超权重成为 decode 带宽的主要消耗者。
参考资料
- Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention(vLLM,arXiv 2309.06180)
- Ainslie et al., GQA: Training Generalized Multi-Query Transformer(arXiv 2305.13245)
- Shazeer, Fast Transformer Decoding (MQA)(arXiv 1911.02150)
- DeepSeek-AI, DeepSeek-V2(MLA,arXiv 2405.04434)
- vLLM 项目,GitHub