
张量并行
把一个矩阵乘本身切开。通信最重、也最依赖高速互联的并行。
机制:行切与列切
Megatron-LM 的洞察:Transformer 的 MLP 与注意力投影可以只用两次通信完成切分。以 MLP 为例,
flowchart LR
    X["X"] --> f["f:identity(列切 A)"]
    f --> XA1["XA₁ → GeLU → Y₁"]
    f --> XA2["XA₂ → GeLU → Y₂"]
    XA1 --> g["g:allreduce(行切 B)"]
    XA2 --> g
g --> Z["Z"]- 第一刀(列切
):GeLU 逐元素独立,各卡算各的部分 ,无需通信; - 第二刀(行切
): ,各卡局部结果相加即为全量——一次 allreduce 合并。
注意力同理(
显存账:权重、激活、参数三丰收
TP=
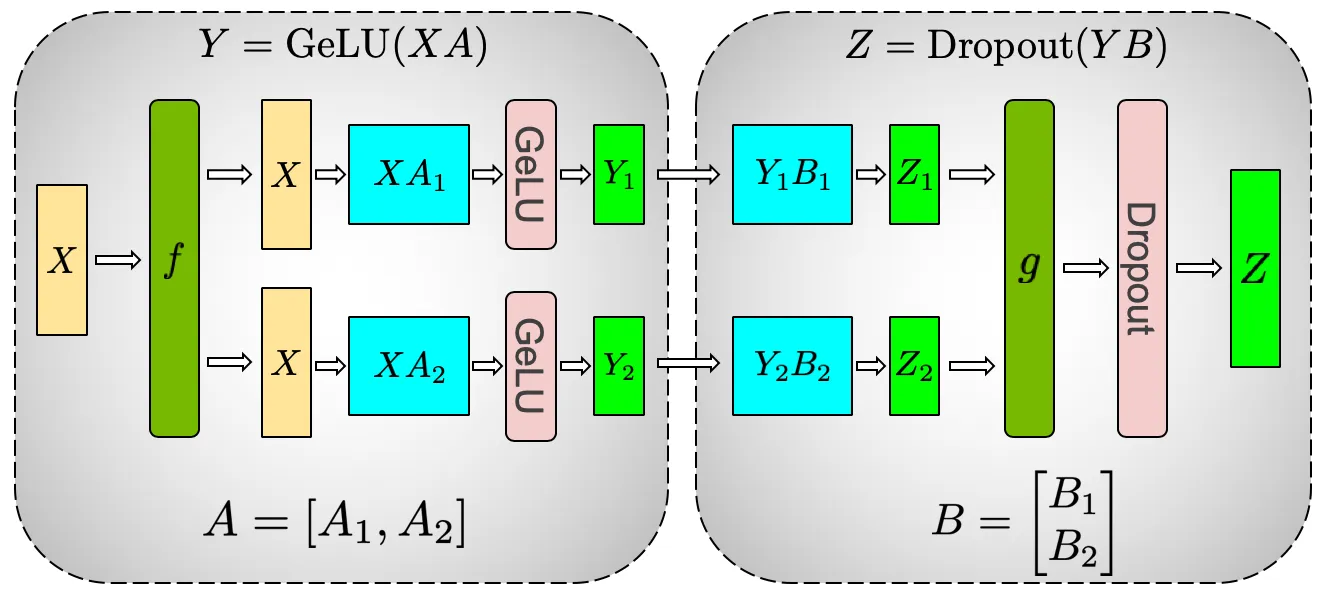
图源:Megatron-LM 论文(arXiv 1909.08053)。
边界:TP 放多大
通信在关键路径上且每层都发生,时间公式代入(超节点篇):NVLink 域内 8 卡单次 allreduce 约 0.25 ms,跨机则慢一个数量级。结论:
- TP 度数 ≤ 单机卡数(8),且留在 Scale-up 域内;
- 更大的权重切分交给 PP(通信稀疏)或 ZeRO-3(通信可重叠);
- TP 的隐含收益:度数增大时 allreduce 数据量不变但分母增大?不——数据量
与 无关,度数越大、通信频次不变而每次参与卡更多,延迟项与网络压力随 上升,收益递减。
深入推导:为什么列切 GeLU 免通信,softmax 却不行
GeLU/ReLU 逐元素作用:
通信量下界。切分
(据 Shoeybi et al. 2019。)
思考题
- TP=8、
(decode)、 、 :每层前向通信量多少?为什么 decode 时 TP 的相对开销比训练时更大? - TP=2 时每卡权重减半,通信也减半吗?
- 为什么不能把 TP 做到 64 卡跨机,用更多卡摊薄权重?
参考答案
- 每层 2 次 ×
MB(BF16)≈ 268 MB;每 token 每层都付。训练时大 batch 的计算时间随 增长而通信量也随 增长(比值不变),但 decode 的计算本身是带宽受限的极薄切片,通信/计算比急剧恶化——TP 对 decode 延迟的伤害远大于训练(见超节点篇 worked example)。 - 否。allreduce 数据量
只与激活大小有关,与 无关;只有权重/状态显存按 减。 - 通信频次 × 层数 × 关键路径不可重叠:64 卡跨机 TP 的每 token 通信时间会超过计算时间几个数量级(超节点篇 worked example 算过 18 倍/跨机);且显存摊薄的需求早已被 PP/ZeRO 满足。
小结
- TP 沿矩阵切:列切免通信 + 行切一次 allreduce,每层 4 次通信、全部在关键路径上。
- 三种状态(权重/梯度/优化器+激活)全按
均摊,是"装不下"的第一刀。 - 度数上限 = 超节点内单机 8 卡;decode 场景的通信/计算比比训练更恶劣。
- 切法已达到通信下界,工程自由度在"放哪"而不在"怎么切"。
参考资料
- Shoeybi et al., Megatron-LM(arXiv 1909.08053)
- Narayanan et al., Megatron-LM v2(arXiv 2104.04473)
- Wang & Komatsuzaki, GPT-NeoX-20B(arXiv 2204.06745,TP 工程实践)